
timrestart wrote:
微軟Nvid...(恕刪)
芯片數據摸底還得靠 SemiAnalysis!今天最新這篇提到了 DeepSeek 擁有的 GPU 數量不是某些人聲稱的 50,000 個 H100,而是 10,000 個 H800 和約 10,000 個 H100,剩下 30,000 左右的 H20,這是 Nvidia 在出口管制法案之後爲中國市場定製的。
SemiAnalysis 的分析表明,DeepSeek 的服務器 CapEx 總額接近 13 億美元,這些 GPU 由 High-Flyer 和 DeepSeek 共享,它們被用於交易、推理、訓練和研究!
文章中最有趣的觀點就是 AI 模型產業與芯片產業的類比,就像在最新一期的 Indigo Talk 中提到的 - 大模型正在商品化,與芯片製造工藝迭代邏輯類似。
1. 前沿能力帶來超額利潤
- 在芯片產業裏,最先進製程(比如台積電領先的 3nm、2nm)往往擁有高額的毛利率。做「落後一代製程」的代工廠只能打價格戰;
- 在大模型市場,「前沿水平的推理/生成能力」 同樣可以定更高的價格,爲早期付費用戶提供獨家或高質量服務,進而獲得溢價;
2. 快速迭代與淘汰
- 芯片工藝每一代很快就更新,AI 模型同理,更新迭代速度越來越快 —— 誰能最先推出下一代「推理/思考」能力,誰就能夠暫時佔領高端市場;
- 同時,過往一代的技術不會立即消失,會在某些場景繼續存在,但利潤和售價往往走低,與新一代「前沿能力」拉開差距;
3. 規模、效率與摩爾定律 / 算力擴張的矛盾
- 芯片製造商要通過更精細的工藝(規模效應)推動晶體管數量的指數增長。但越是先進製程,研發與設備投入越是驚人;
- AI 模型也在追求「更大規模」與「更高效率」的矛盾:一方面大家想訓練更大的模型來突破能力上限,另一方面也在積極提升訓練/推理效率、降低成本;
- Jevons 悖論:當每次訓練或推理變得更便宜時,模型推理調用量會激增,總體算力需求反而上升(如同手機、雲計算普及後算力需求的爆炸式增長)。
4. 技術領先者的地位與盈利
- 芯片代工龍頭(TSMC)之所以能持續保持高盈利,在於其維持了對下一代工藝節點的快速投入和良率領先,使競爭對手短期很難追上;
- 大模型賽道里,OpenAI、Google、Anthropic、Meta 等會通過持續大規模資金投入在新一輪「算法+算力」中領先。如果哪家公司短暫落後,就必須以降價或開放等策略跟進;
因此,AI 模型的商業化進程很可能出現類似芯片產業的「前沿與追隨」並存格局:
- 「前沿模型」 依靠新一代推理能力賺取高額利潤;
- 「追隨模型」 則以相對較低價格搶佔中低端或更多場景市場;
- 雙方都持續增長對算力(GPU 等硬件)的需求,進一步刺激芯片企業的發展。
最後總結下對 Nvidia 的影響:
- 短期內:DeepSeek 等高效模型的出現非但不會削弱 GPU 需求,反而加劇爭搶,Nvidia 的 H100/H200 價格和市場需求高企;
- 中長期:前沿模型升級與新一輪「能力競賽」將繼續擴大整體算力需求,Jevons 悖論帶動 GPU 採購量不降反升,維繫甚至增進 Nvidia 在 AI 訓練/推理硬件領域的盈利地位;
- 只要有足夠的前沿芯片投入市場,在短期內很難被其它產品或自研 ASIC、國內 GPU 芯片替代,Nvidia 將保持對 AI 訓練/推理硬件市場的統治地位;
- 出口管制對中國買家採購 Nvidia 高性能芯片會帶來一定阻力,但市場仍會盡可能在政策縫隙中購入高端硬件,或轉向 Nvidia 專爲中國市場推出的「縮水版」高端產品,整體需求依舊旺盛;


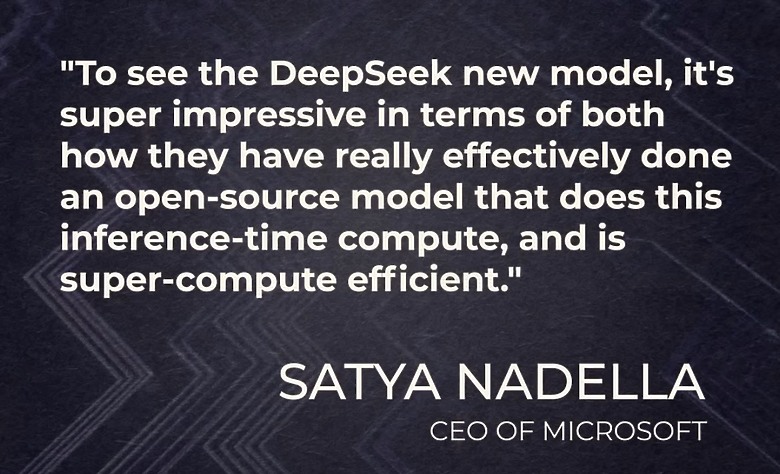
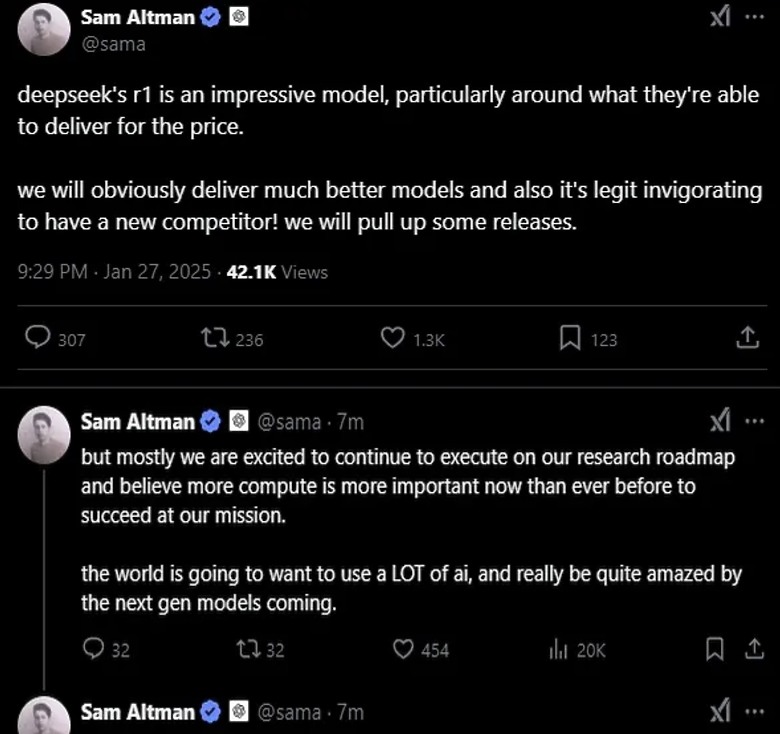
大神說讚是說算法不錯
但是還是蒸餾法呀~
這個世界上
很多鄉民只要名人代言
就會腦補到其他方面~
更有趣的是
越是教育程度越低的鄉民
越沒有獨立判斷能力的鄉民
喜歡引經據典
如愛因斯坦說什麼
以為得了諾貝爾獎
就是上帝什麼都是對的
偏偏愛因斯坦在量子力學
跟別人打賭沒一次贏
因他不相信
還說是
Spooky reaction ⋯
好像在解一個證明題
在答案卷上
只留一句話說
愛因斯坦覺得不錯
老師大概直接劃掉給鴨蛋🥚⋯⋯
在美國諾貝爾得獎人
投論文或申請計劃
內容有瑕疵
還是會被退件
在亞洲可不得了
光靠人名可以吃喝一輩子
但在美國可不是這樣⋯
———-
鄉民越多其實越好
其實也正常
社會本來就是20/80法則
股市更是如此
總有割不完的韭菜⋯

從 Semianalysis 這篇報道的觀點出發,高效 AI 模型並不會讓 Nvidia 的市場萎縮,反而更可能助推 Nvidia 的先進 GPU 需求和全球出貨量持續上行。

個人積分:16693分
文章編號:91050927
Sinfield wrote:
timres...(恕刪)
近日,加州大學伯克利分校的研究人員開發出了中國開發的 AI 語言模型DeepSeek R1-Zero的小規模語言模型複製品,成本約30美元。語言模型TinyZero是由校園研究生Jiayi Pan和其他三名研究人員領導的項目,由校園教授Alane Suhr教授和伊利諾伊大學厄巴納-香檳分校助理教授Hao Peng指導。
他說,TinyZero 的開源性質允許人們下載代碼並嘗試訓練和修改模型。「小規模複製非常容易實現,而且成本非常低,即使人們將其作爲實驗的副項目,」潘說。「從項目一開始,我們的目標基本上就是揭開如何訓練這些模型的神祕面紗,更好地理解它們背後的科學和設計決策。」
但是人家不會說只花30美元就開發出一個AI軟體,而且也是開源~
個人積分:5369分
文章編號:91051596

個人積分:442分
文章編號:91051611

個人積分:16693分
文章編號:91052456
爬山的阿光 wrote:
Sinfie...(恕刪)
大神說讚是說算法不錯
但是還是蒸餾法呀~
這個世界上
很多鄉民只要名人代言
就會腦補到其他方面~
更有趣的是
越是教育程度越低的鄉民
越沒有獨立判斷能力的鄉民
喜歡引經據典
如愛因斯坦說什麼
以為得了諾貝爾獎
就是上帝什麼都是對的
偏偏愛因斯坦在量子力學
跟別人打賭沒一次贏
因他不相信
還說是
Spooky reaction ⋯

好像在解一個證明題
在答案卷上
只留一句話說
愛因斯坦覺得不錯
老師大概直接劃掉給鴨蛋🥚⋯⋯
在美國諾貝爾得獎人
投論文或申請計劃
內容有瑕疵
還是會被退件

在亞洲可不得了
光靠人名可以吃喝一輩子
但在美國可不是這樣⋯
———-
鄉民越多其實越好
其實也正常
社會本來就是20/80法則
股市更是如此
總有割不完的韭菜⋯

個人積分:4935分
文章編號:91052491
個人積分:16693分
文章編號:91052562
個人積分:227分
文章編號:91053657
個人積分:5369分
文章編號:91054229
個人積分:6988分
文章編號:91054324






















關閉廣告
評分
複製連結
請輸入您要前往的頁數(1 ~ 10)