隨著生成式 AI 逐漸融入影像製作、內容開發與自動化工作流程,創作者對筆電的需求,也從傳統的剪輯、修圖效能,延伸到大型語言模型的本機部署與推論能力。而搭載最新 NVIDIA RTX Spark 平台的華碩 ASUS ProArt P14 (H7407),便將大容量 LPDDR5 統一記憶體、GPU 加速能力帶進更便於攜帶的 14 吋機身,讓地端 AI 工作環境能跟著創作者移動。
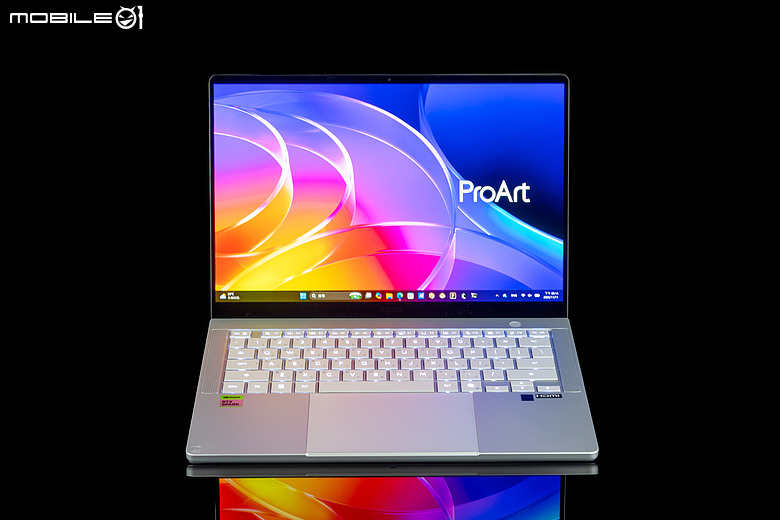
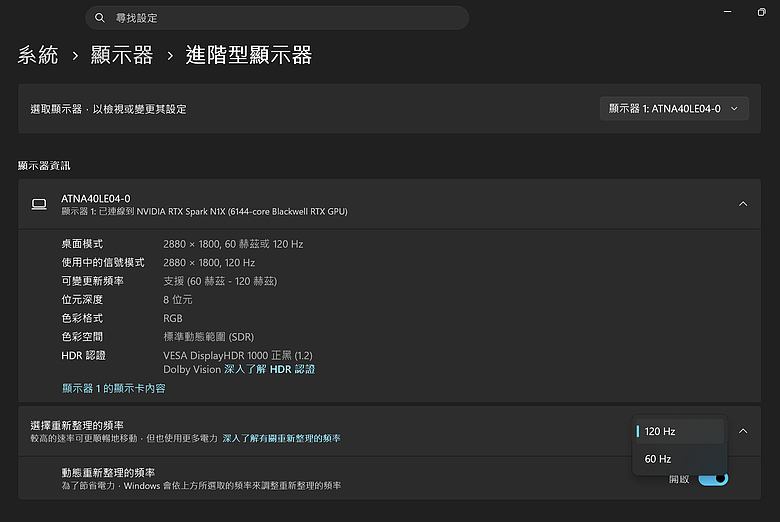
這次 JB 介紹的配置採用 RTX Spark N1X 晶片,整合 20 核心 CPU、具備 6,144 個 CUDA 核心的 Blackwell RTX GPU,並搭配 3K 120Hz 的 ASUS Lumina Pro OLED 觸控螢幕,在約 1.48kg 的重量下,納入 90Wh 鋰電池與三組 USB 4 連接埠和 SD 4.0 讀卡機。從運算資源、畫面呈現到素材傳輸,ProArt P14 (H7407) 都展現出明確的專業創作定位,也讓需要往返工作室、拍攝現場與客戶端的使用者,有了兼顧地端 AI 應用與行動性的選擇。
▌外觀開箱 ▌
- 筆電上蓋
- 筆電尾端
- Logo
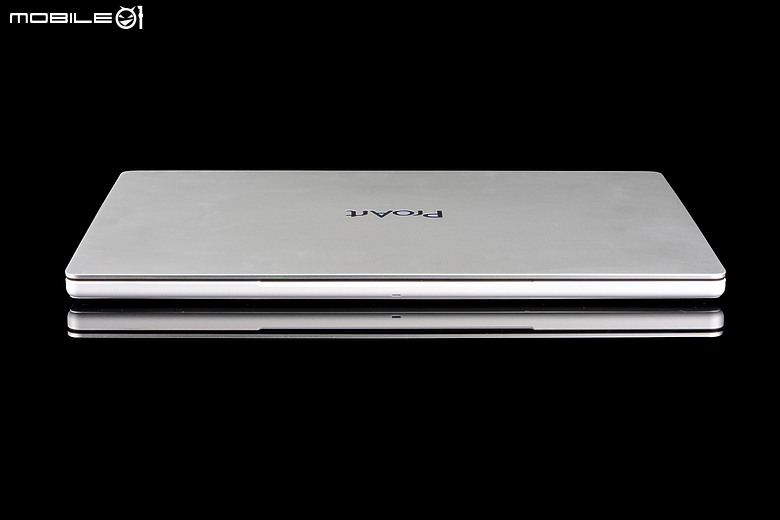
- 筆電前端
- 指示燈
- 筆電左側 I/O
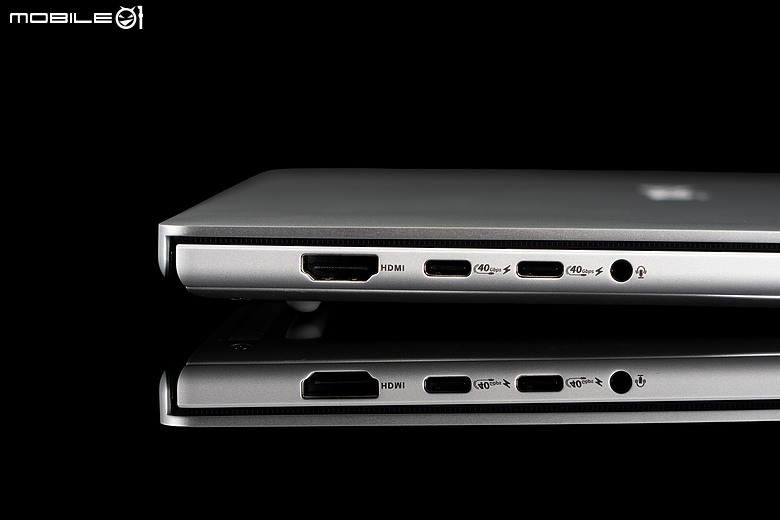
- 筆電右側 I/O
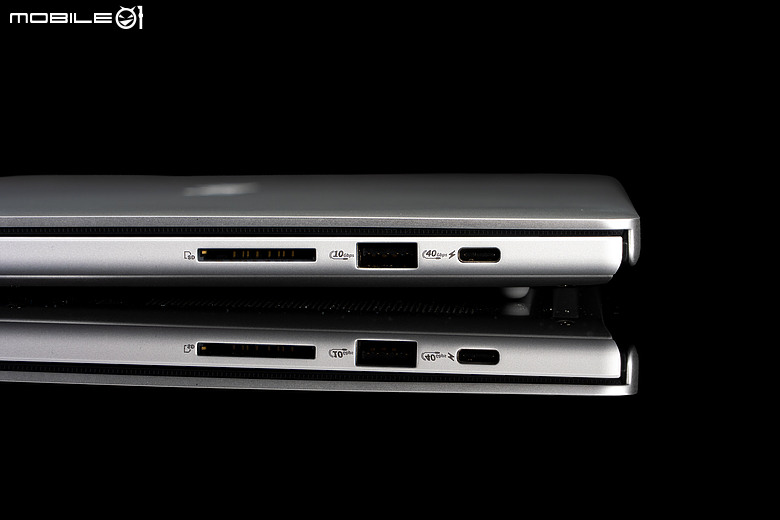
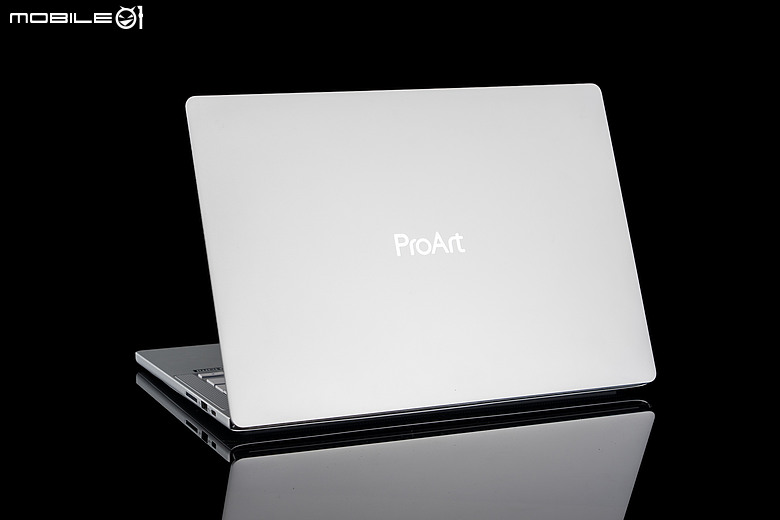
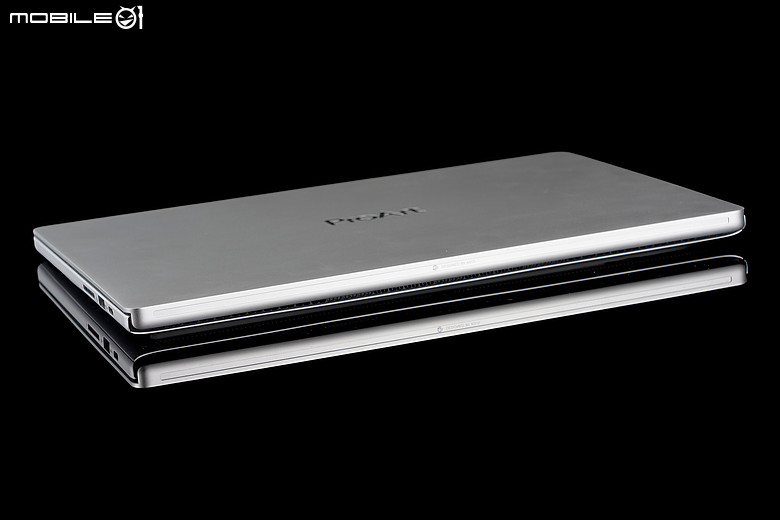
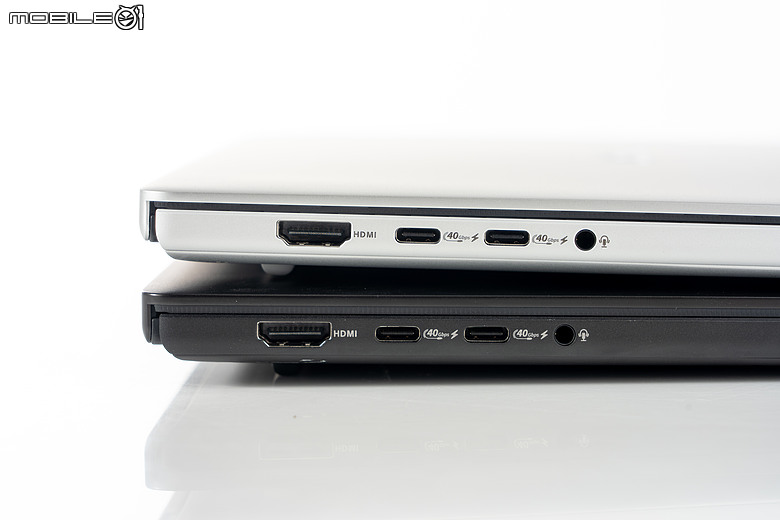
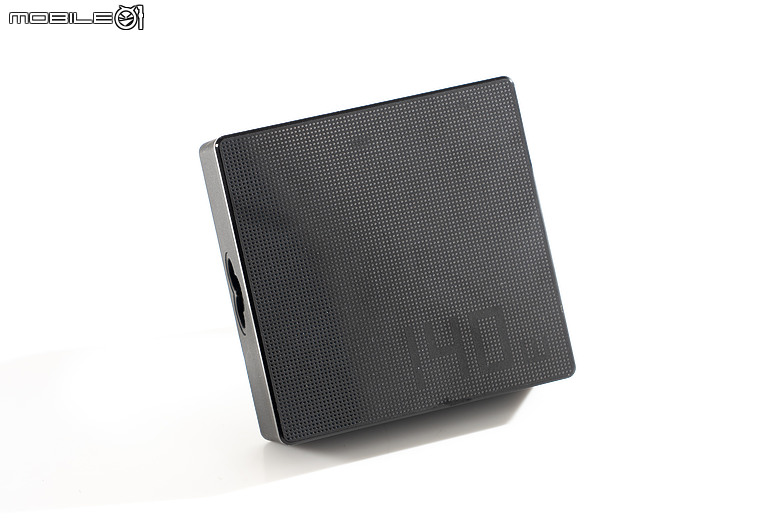
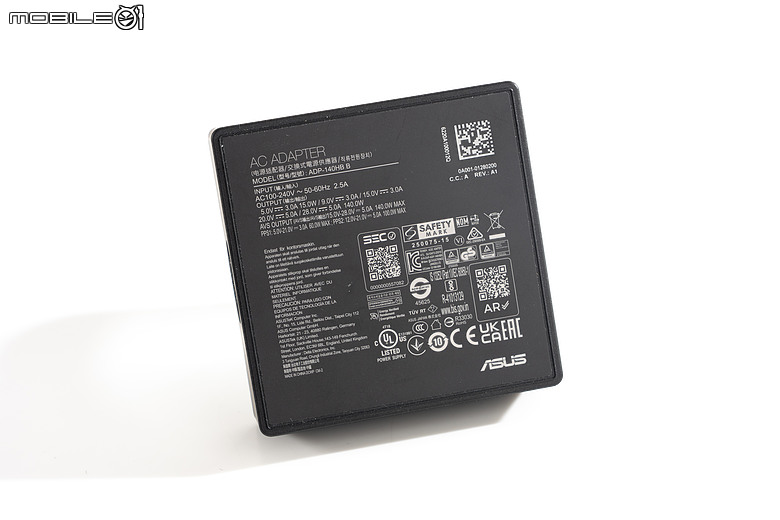
迥異於去年的 ProArt P16/P14,這次 RTX Spark 平台的新機取消了華碩特規的 Slim Power Jack、並改用 USB 4.0 Gen 3 Type-C 充電,主因在於 RTX Spark 平台採用高能效 Arm 單晶片整合架構,將整機滿載峰值功耗從前代的 200W 大幅壓低至 140W 以內,剛好能由支援最新 USB PD 3.1 (28V/5A、140W) 規範的 Type-C 單線直接餵飽全速效能,無需再為高瓦數保留特規直流接頭,同時更藉此釋放機身內部空間達成極致輕薄化

- 顯示螢幕
- 顯示更新率
- 視訊鏡頭
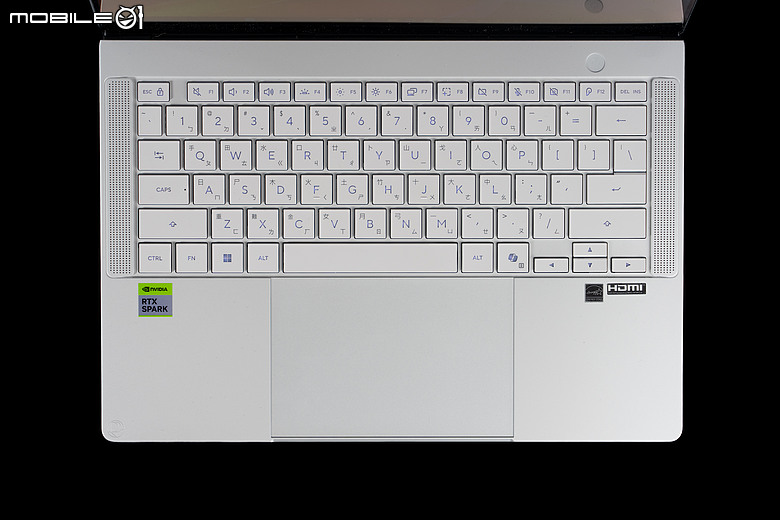
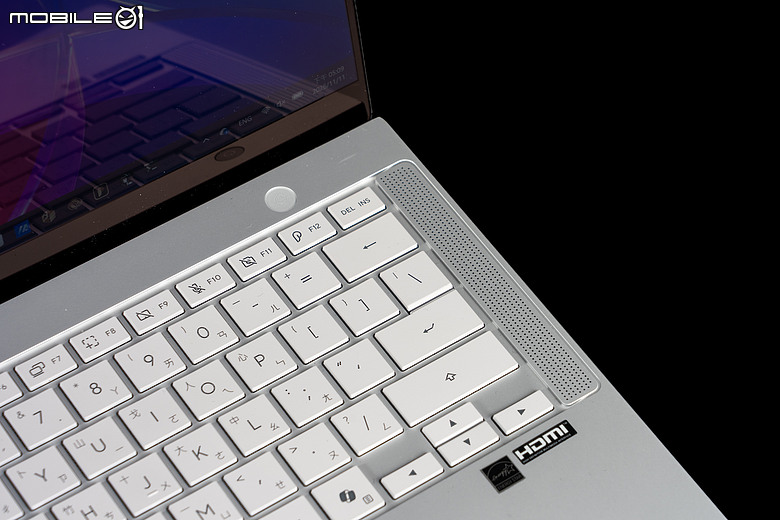
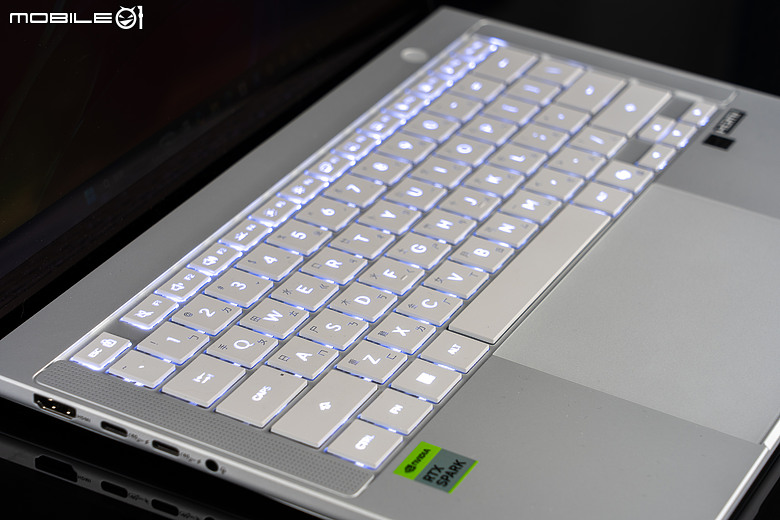
- 筆電鍵盤部
- 電源鍵
- ProArt Logo
- 鍵盤背光開
- 鍵盤背光關
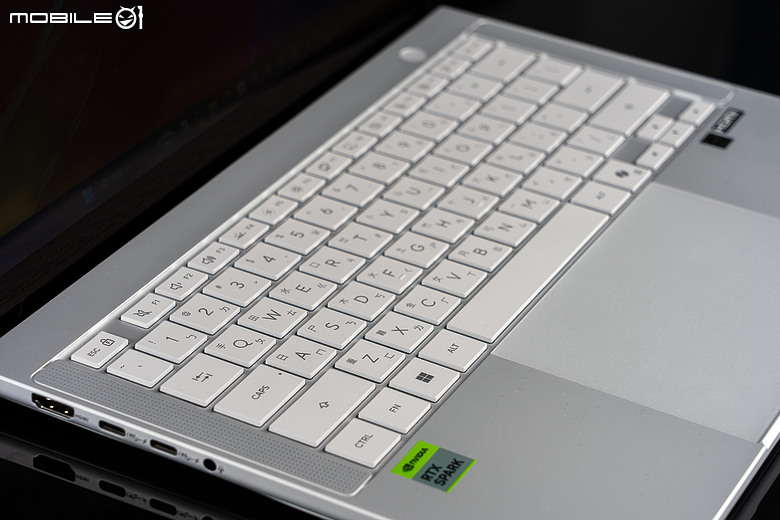
而鍵盤部下緣則配置大尺寸「觸覺回饋觸控板」,取代傳統的機械式微動結構,透過內建高精度壓力感測器與線性振動馬達,整塊觸控板從邊緣到角落皆能提供均勻、清脆且靈敏的按壓反饋,解決傳統觸控板上方區域按不動的死角痛點。
- 筆電底蓋
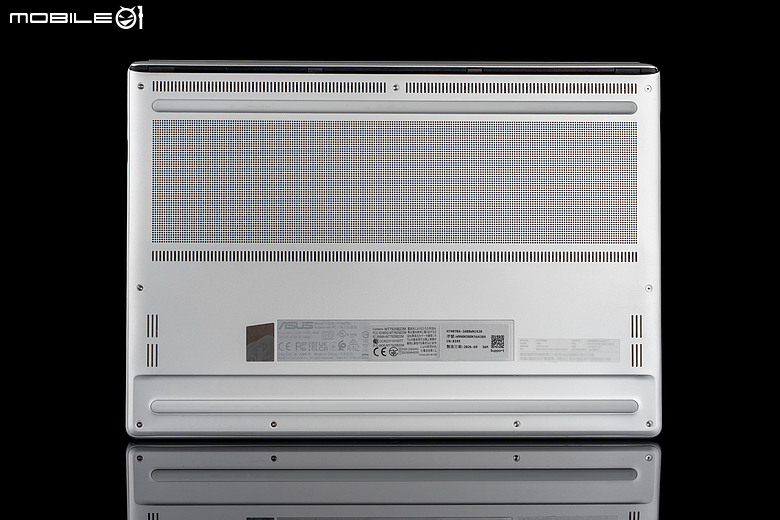
- 拆卸示意
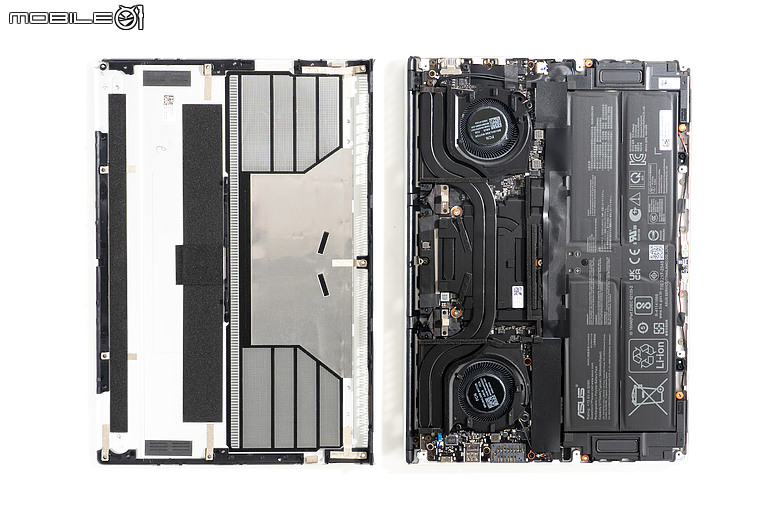
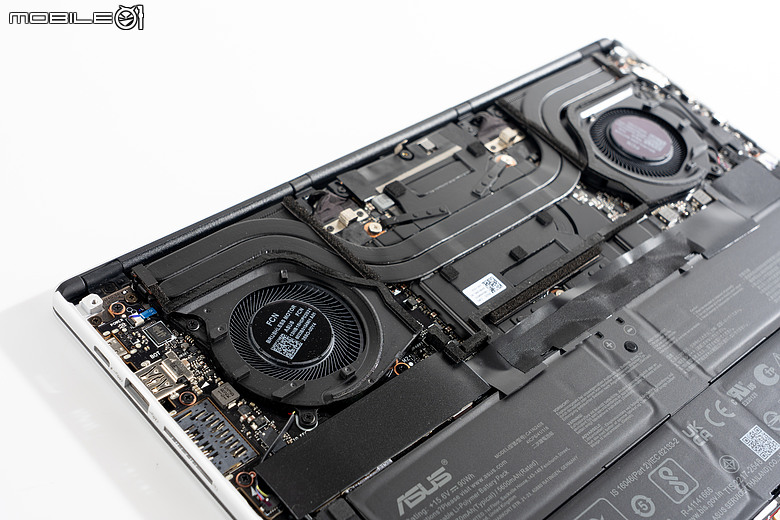
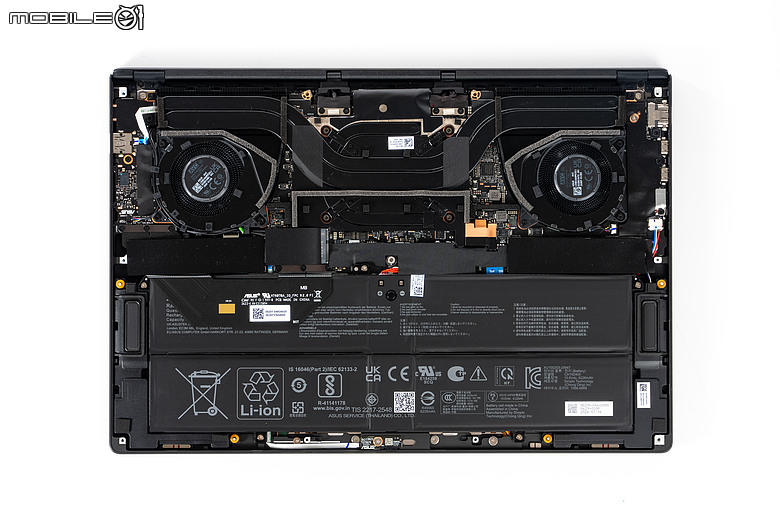
- P14|筆電內部組件
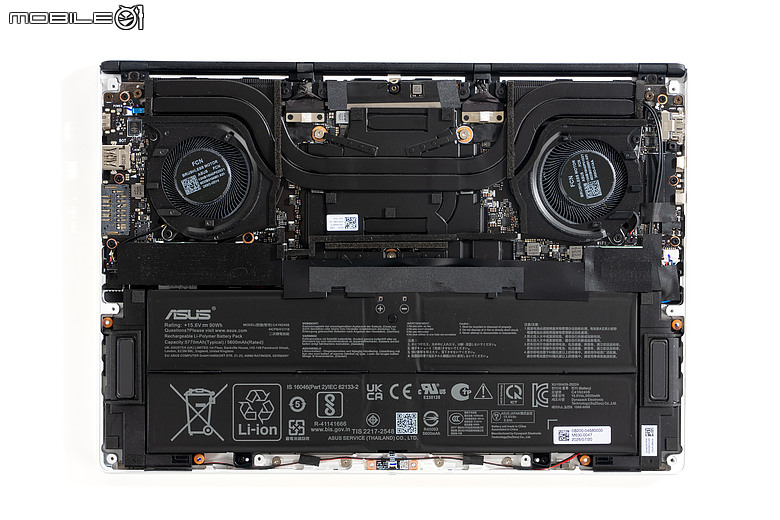
- 雙風扇
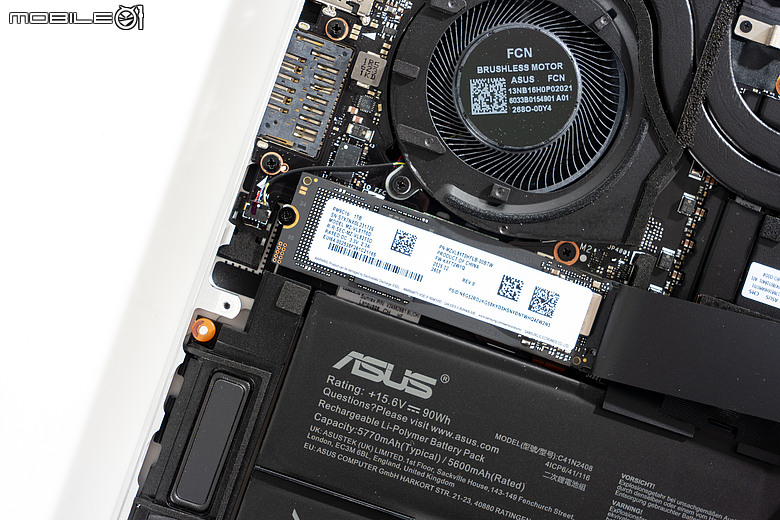
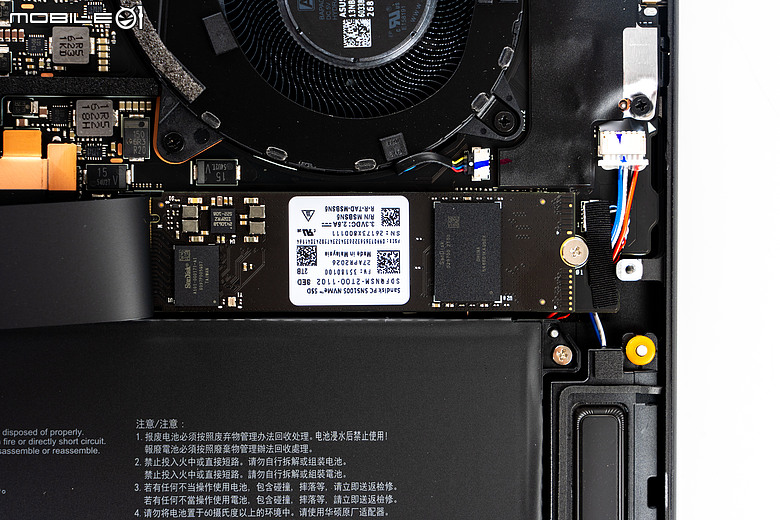
- SSD
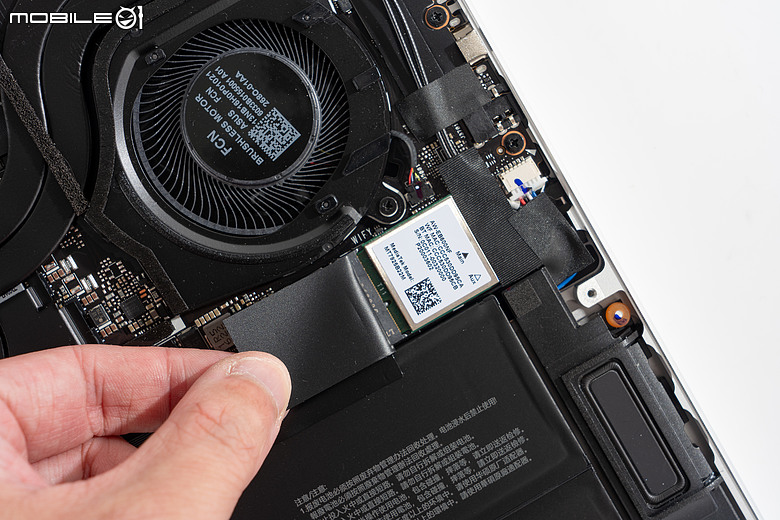
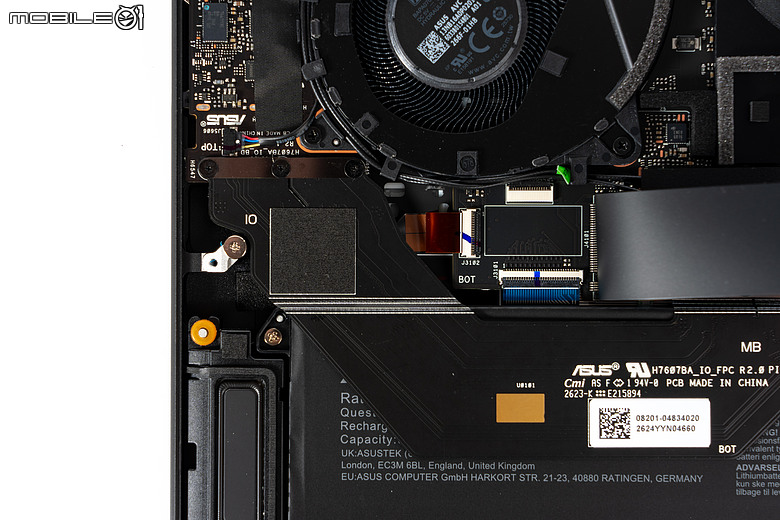
- 無線通訊晶片
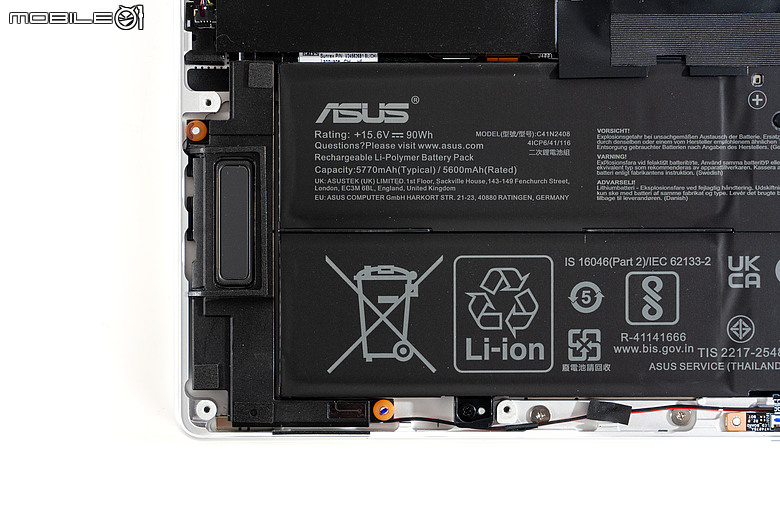
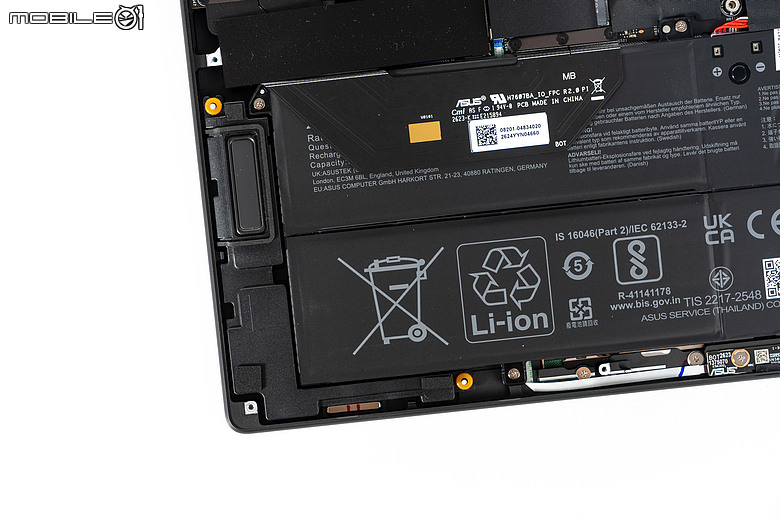
- 鋰電池
儲存空間部分僅配置單一組 M.2 2280 SSD 插槽,雖然插槽本身具備 PCIe 5.0 x4 高速規格,但出廠預載的是 PCIe 4.0 介面的三星 PM9C1b 1TB,對於有龐大素材儲存需求的創作者而言,日後若想擴充,須採取整條替換的方式升級,所幸插槽空間可相容雙面顆粒 SSD,最高支援擴充至 4TB 容量,也能藉此完全解放該插槽的 PCIe 5.0 頻寬潛力。
- P16|內部組件
- SSD1
- SSD2
- 鋰電池
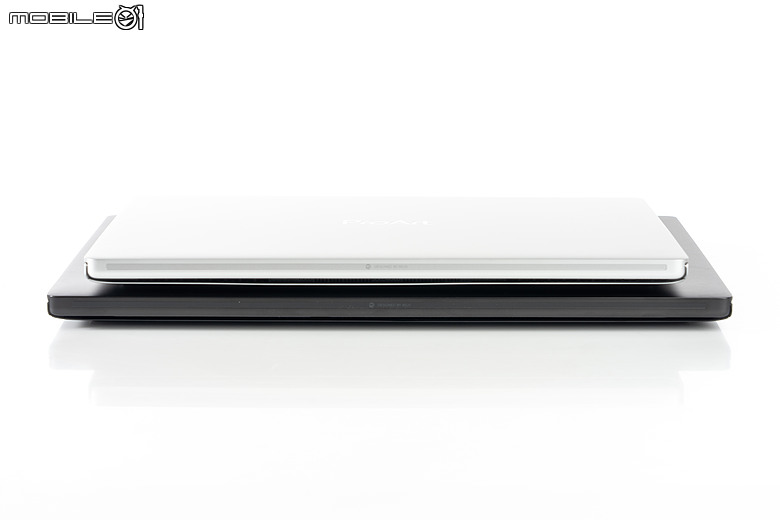
- P14/P16|上蓋
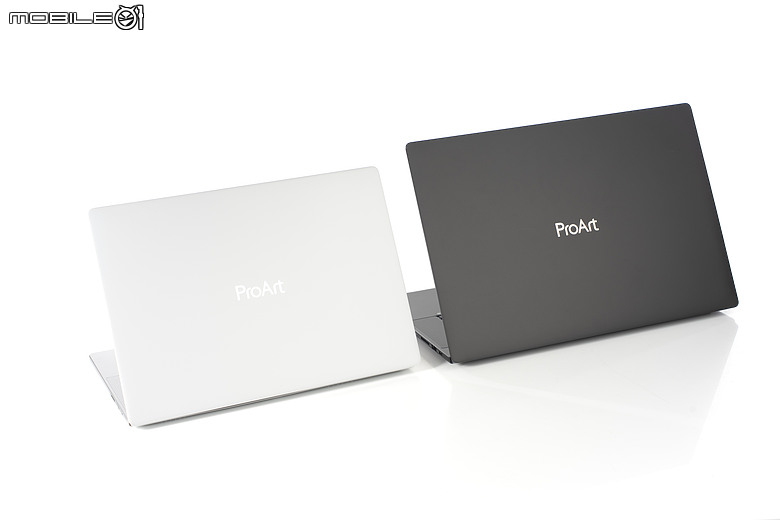
- 正面
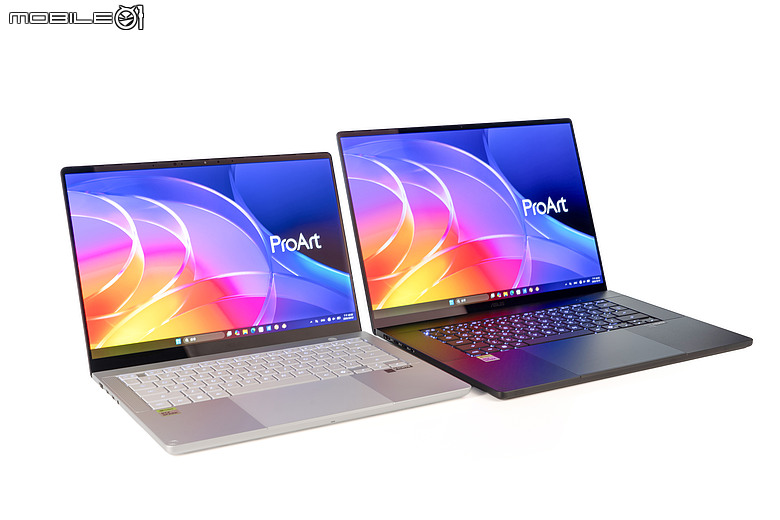
- 寬度
- 右側 I/O
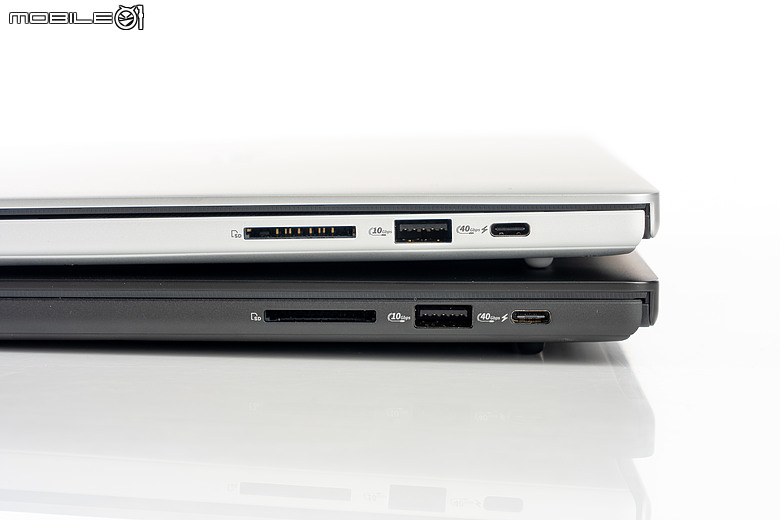
- 左側 I/O
- 140W 變壓器
- 變壓器背面
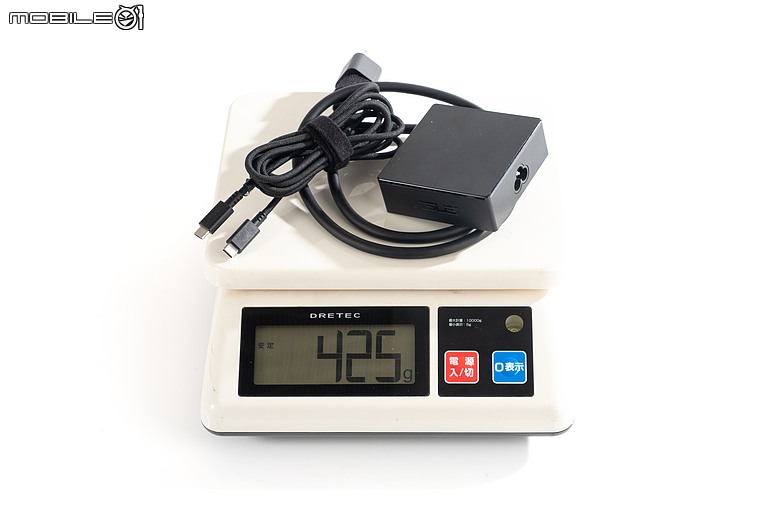
- 變壓器與線材重量
- 筆電本體重量
線材則採分離式配置,除了標準 3-Pin 電源線外,更直接隨附一條質感與耐用度俱佳的編織材質 USB-C 對 USB-C 傳輸線;實際上秤測量,變壓器連同線材重 425g,比過去動輒6、700g 的 200W 磚形變壓器大幅減負,對需要頻繁攜帶外出的創作者十分友善
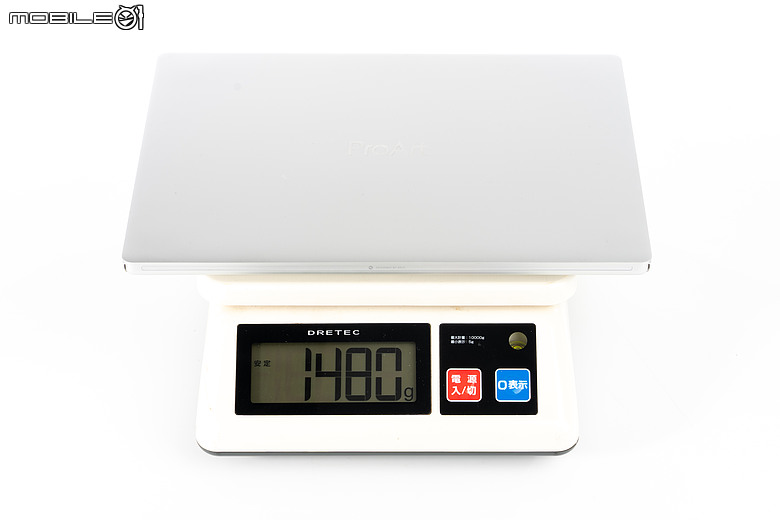
 至於筆電本體經量測則是 1.48Kg,雖稱不上超輕薄,但也是相對沒有負擔的重量了。
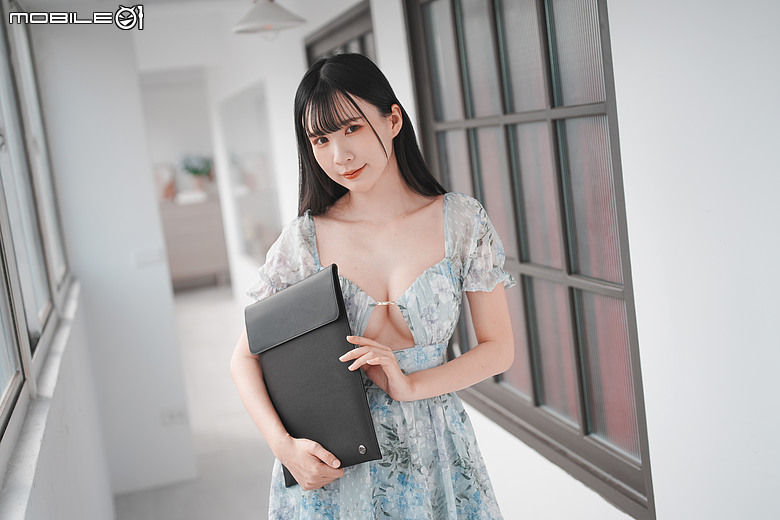
為了方便創作者隨身攜帶外出,華碩提供 ProArt 筆電保護套,其外觀採用俐落洗鍊的純黑信封式翻蓋設計,表面選用觸感細膩且具備基礎防潑水與抗刮特性的霧面 PU 皮革材質製成,邊緣搭配工整車縫線強化結構,右下角則低調鑲嵌了一枚銀色 ProArt 品牌金屬圓標點綴質感。內裡配備柔軟防刮的絨面緩衝襯層,能緊密貼合 14 吋纖薄機身並抵禦日常放進背包時的碰撞與刮傷;掀蓋處則採隱藏式磁吸閉合設計,拿取筆電時無需擔心拉鍊刮傷金屬機殼
▌軟體體驗 ▌
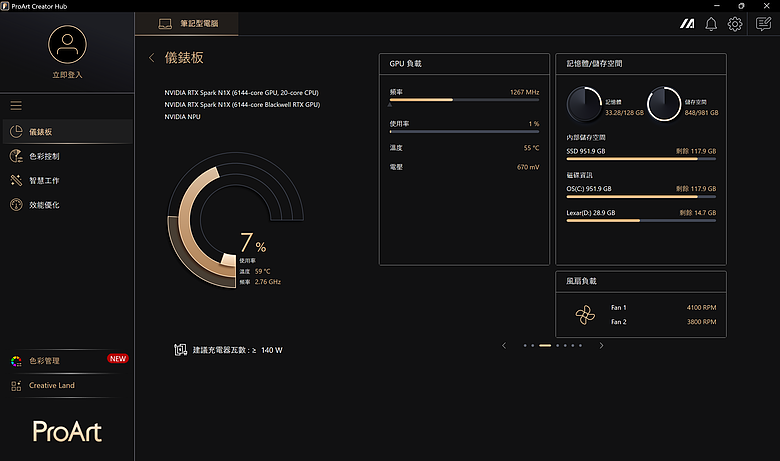
- ProArt Creator Hub|儀錶板
- 操作模式
- GPU 負載
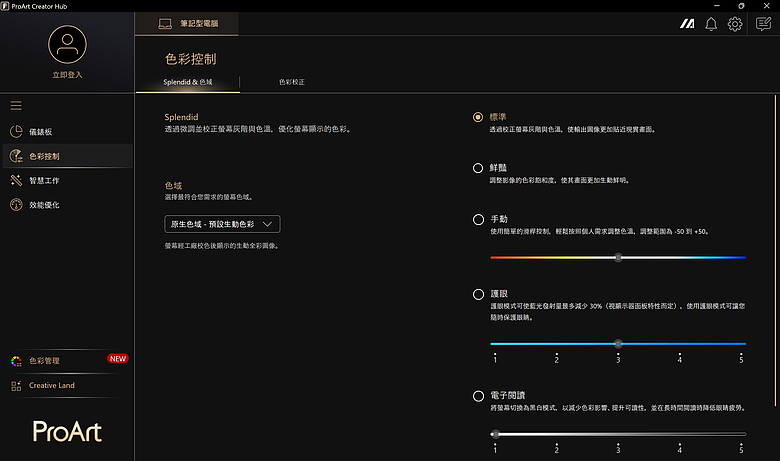
- 色彩控制
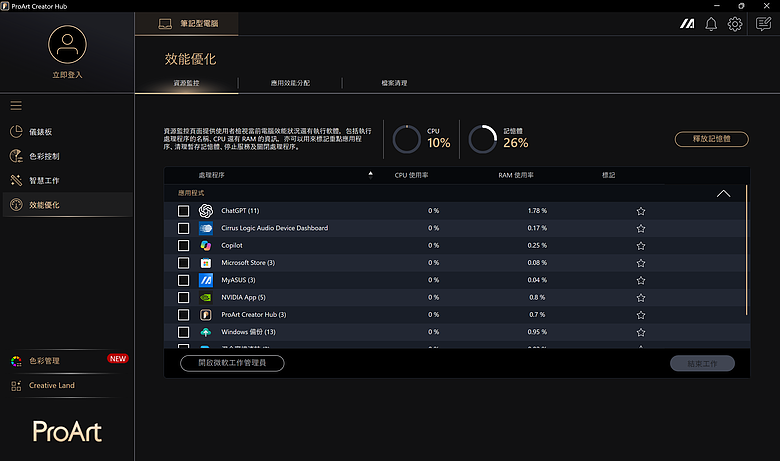
- 效能優化
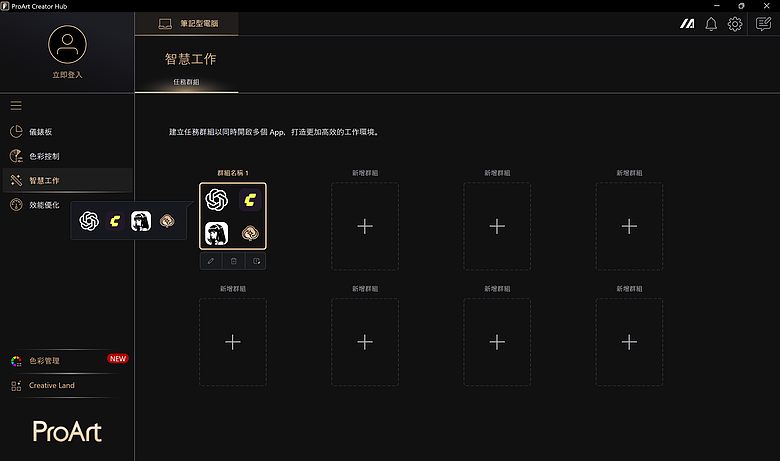
- 智慧工作
- Hermes Agent
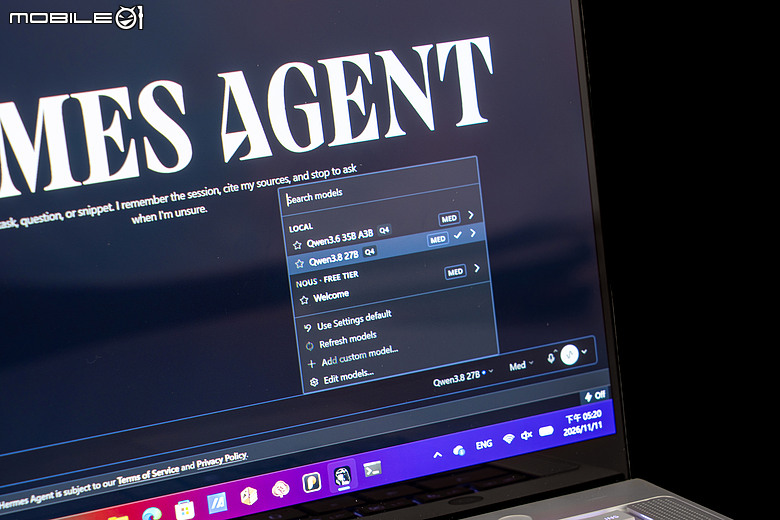
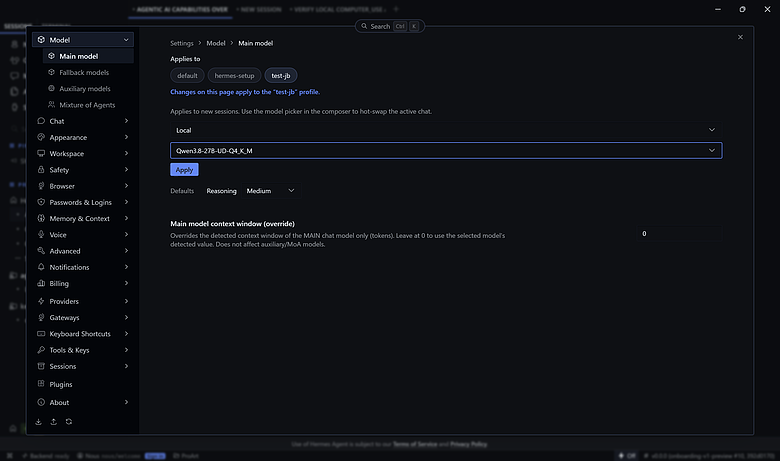
- Hermes Agent AI 模型管理
- Hermes Agent AI 模型下載
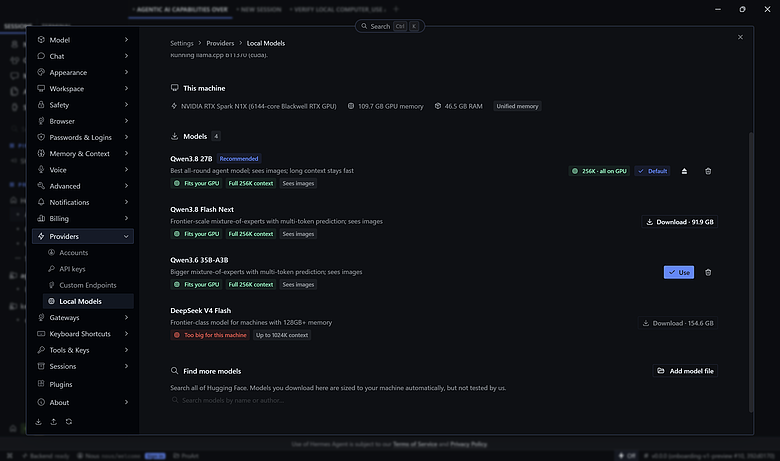
它的操作介面跟我之前使用的 LM Studio 頗為相似,但功能豐富許多;地端大型語言模型可至設定中的「Providers / Local Models」選取,系統預設為 Qwen3.8 27B,若模型參數量超出硬體負荷,就會像清單中第四個 DeepSeek V4 Flash 那樣以紅字標示提醒;想要尋找其他模型的話,直接在介面下方搜尋即可,Hermes Agent 已經直接與 Hugging Face 對接,下載切換相當方便~
JB 平常用 AI 還是以雲端為主,像是網頁版聊天、API、命令列工具等;在自己電腦上部署模型、接 MCP (讓 Agent 呼叫外部工具的連接方式)則不太熟悉,因此這次花了點時間測試 AI Agent,由 Hermes Agent 負責調度工具,語言模型選用本機 Qwen3.8 27B Q4,生圖則使用 MuseTree 與 ComfyUI。使用者可用一句中文提出需求,由 Agent 接著處理提示詞與工具操作,背後的服務是否啟動,也成了整套流程能否順利執行的關鍵。
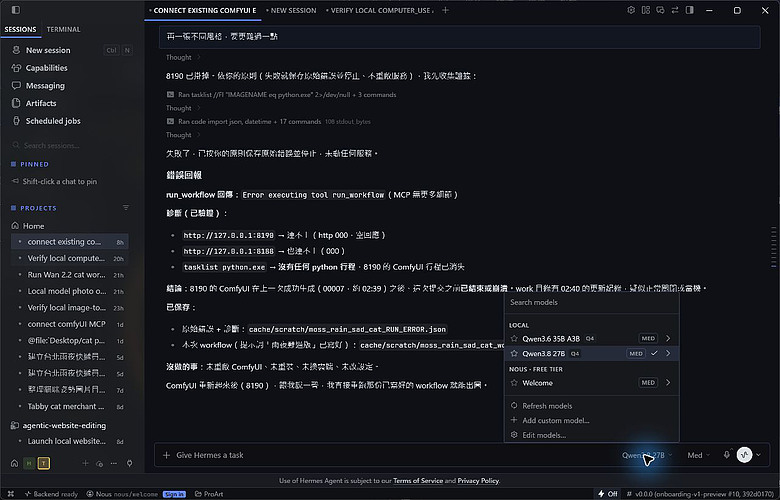
有別於雲端 AI 服務登入成功就能使用,設定地端 AI 雖然在模型選用上有更多選擇 (Huggingface 或自訓練模型),但仍需在 Agent 介面上設置正確才能正常執行。相較之下,雲端服務都會把環境配置藏在背後,不像地端工具把一部分維護工作留在電腦上,所以如果你跟我一樣是地端 AI 小白,那可能會花很多時間在處理這個問題...
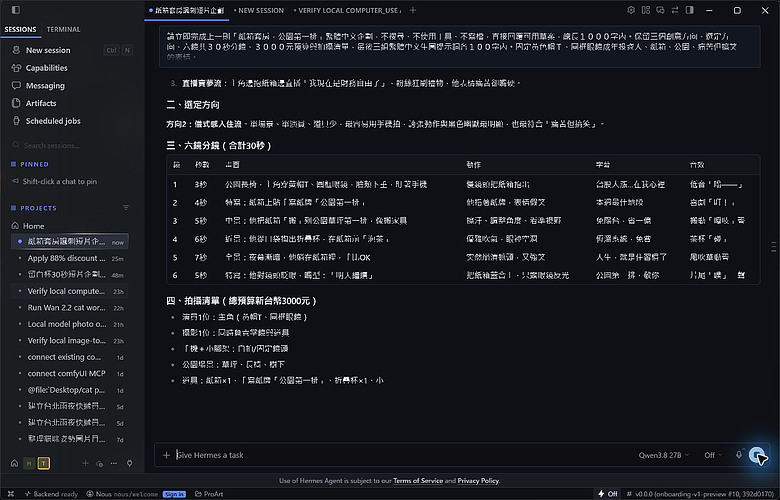
因為做出來的東西不太好看,JB 就直接說結論─地端 AI 在創作前期的實用性相當明確,能把文字構想轉成可供討論的圖片或腳本分鏡,也能透過 Agent 呼叫本機工具,直接處理檔案與執行修改,讓工作從對話延伸到具體成果。以圖片創作來說,生成結果已足以支援概念發想與提案草圖,文字指令的人物情緒、場景與主要物件都能呈現出來,不過,Qwen 在中文字以及指定局部修改等精確要求,仍是較難掌握的部分,反覆生成也不一定能得到正確結果。
- 分鏡腳本推論過程
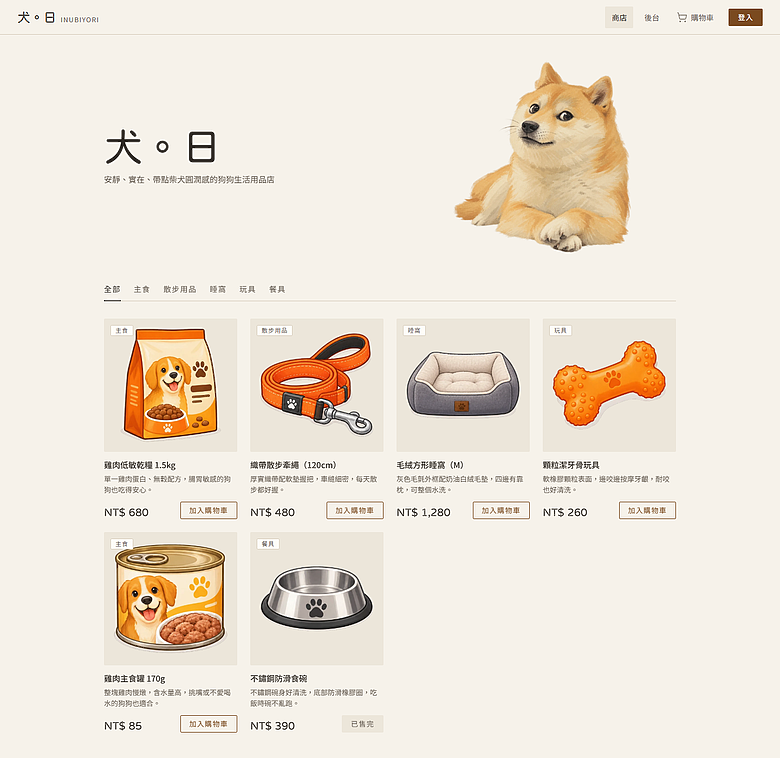
- 網站修改前
- 網站獨立驗證結果
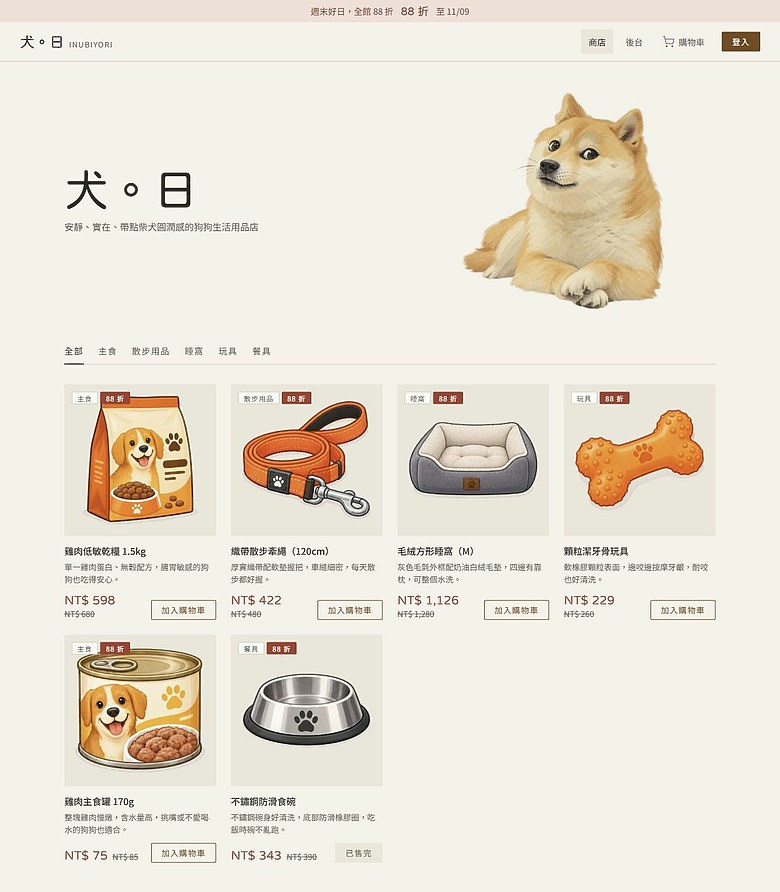
Agent 的價值也體現在具體操作上,在請地端 AI 寫網站的測試中,Hermes Agent 能讀取程式碼 readme 並依照其中提到的開發案例去改動,並沿用既有的函式,正確完成商品的折扣變動。不過,Banner 出現重複文字,也自行加入未要求的截止日期,代表它在範圍明確、已有工具入口的任務上具備實用性,成果檢查仍是工作流程的一部分,以目前的使用體驗來說,將固定、重複的小型任務交給 Agent,已經有助於減少人工操作。
實際等待時間則要看完整任務,不能只看模型生成速度。這次 ComfyUI 產生圖片約需一分鐘,但加上 Agent 前置處理、工具呼叫與結果回報,整體約花了十個半分鐘。這也說明地端 AI 的使用效率,同時受到模型、工具串接與任務設計影響;短篇改稿我可能會傾向於雲端 AI 來處理,如果是多步驟工作則更適合先交辦地端 AI,再利用等待時間處理其他事情。
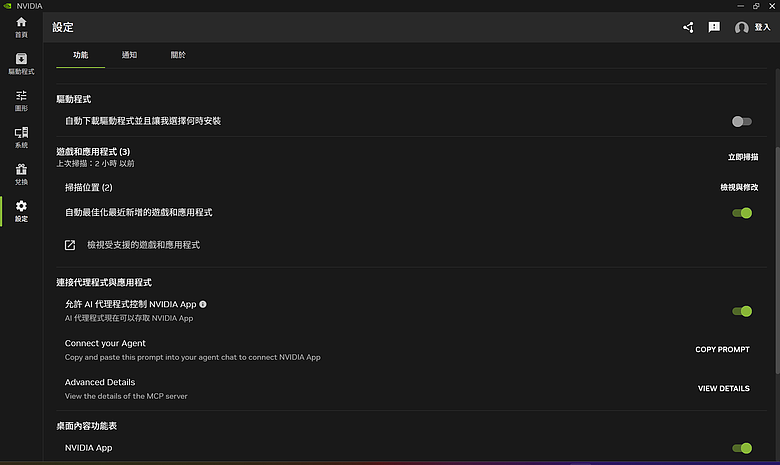
- NVIDIA App|記憶體分配
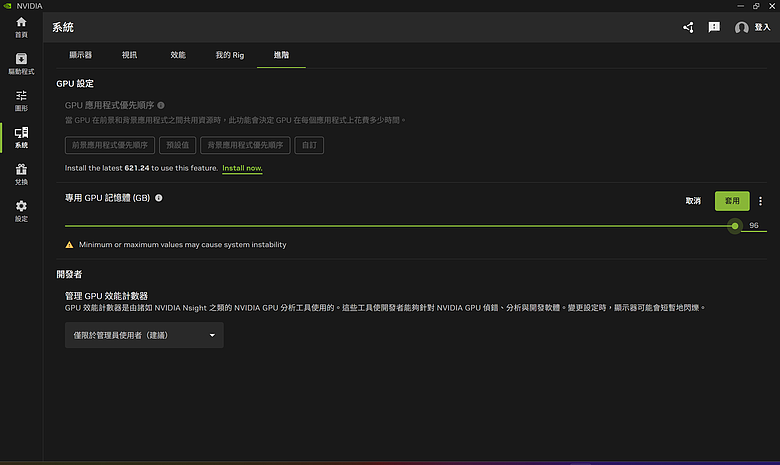
- Agent 可控制
ASUS ProArt P14 (H7407BA) 重點規格:
作業系統:Windows 11 專業版
處理器:NVIDIA RTX Saprk N1X
顯示晶片:NVIDIA Blackwell RTX 6144 核心 GPU
儲存裝置:1TB M.2 NVMe PCIe 4.0 SSD (插槽為 M.2 2270 PCIe 5.0)
記憶體:128GB LPDDR5X (On Board)
顯示螢幕:14 吋 ASUS Lumina Pro OLED 面板 (3K 2880x1800 解析度 / 120Hz 更新率 / 0.2ms 反應時間 / 100% DCI-P3 色域 / 1600 尼特峰值亮度 / PANTONE 色彩認證)
I/O 埠:
3x USB 4.0 Gen3 Type-C (支援顯示及充電)
1x USB 3.2 Gen2 Type-A
1x SD 4.0 讀卡機
1x HDMI 2.1 FRL
1x 3.5mm 複合式音源插孔
通訊:Wi-Fi 7 (802.11BE) / Bluetooth 5.4
電池:90Whrs 充電式鋰電池
尺寸:310.7 x 218.9 x 13.9~15.9 mm
重量:1.48Kg
建議售價:254,999 元,本文測試機種為 249,999 元
▌效能測試 ▌
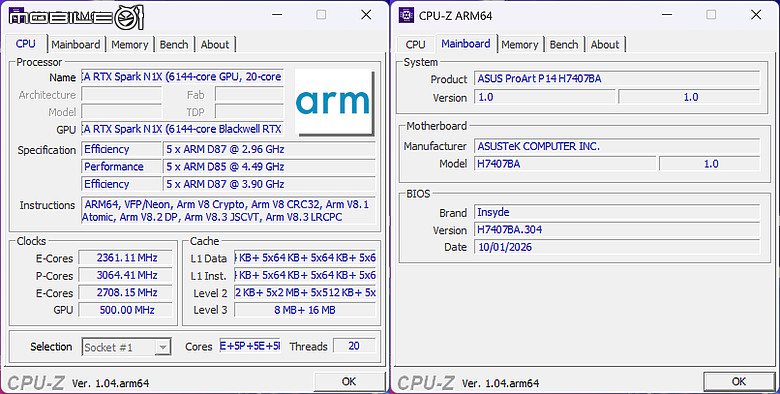
RTX Spark N1X 採用 Arm 架構,這台 ProArt P14 搭載 20 核心 CPU 與具備 6,144 個 CUDA 核心的 Blackwell RTX GPU,運行 Windows 11 Pro 作業系統,CPU、GPU 與大容量記憶體整合在同一平台上,是它與常見 x86 處理器搭配獨立顯示晶片筆電的主要差異。此外,RTX Spark 具備原生 CUDA 支援、高達 1 PFLOPS FP4 AI 算力,地端 AI 模型的參數最高則是來到 120B。
統一記憶體對地端 AI 的價值,主要在於承載更大規模的模型,當使用需求擴展到 70B、甚至超過千億參數的模型,記憶體容量便成為部署時的重要條件,即使採用量化降低模型體積,執行時仍須容納模型權重、上下文快取與其他運算資料,這是過去 32 GB、64GB 所無法達成的成果。
▓ 處理器效能測試:
- 處理器資訊
- CPU-Z ARM64 效能
- CINEBENCH 2026 效能
- CINEBENCH 2024 效能
- CINEBENCH R20 效能
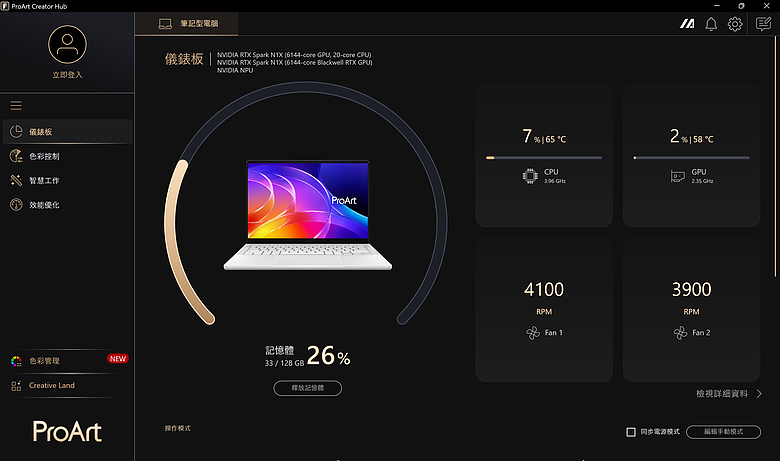
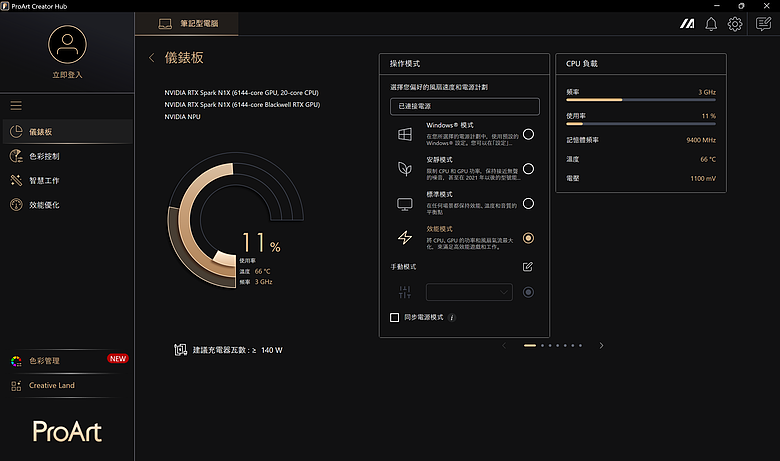
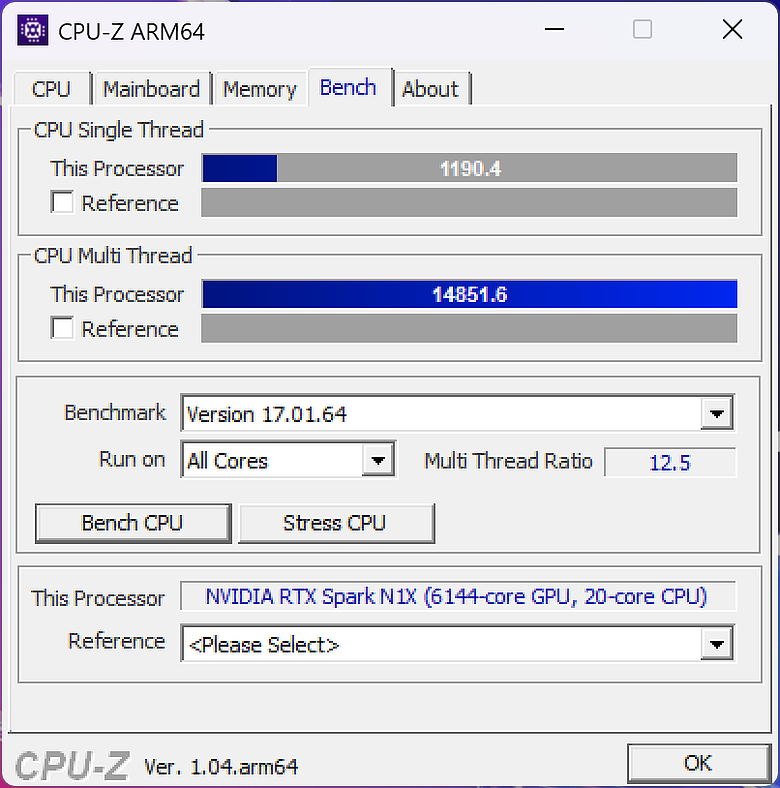
進入到效能測試,我將 ProArt P14 接上電源並在 ProArt Creator Hub 啟用效能模式,其在 CPU-Z 中測得單執行緒 1190.4 分、多執行緒 14851.6 分,改以純電池供電,仍能跑出單執行緒 1172.9 分、多執行緒 14244.9 分的成績,前後效能落差僅為 1.47%、4.08%,落差可以說相當小
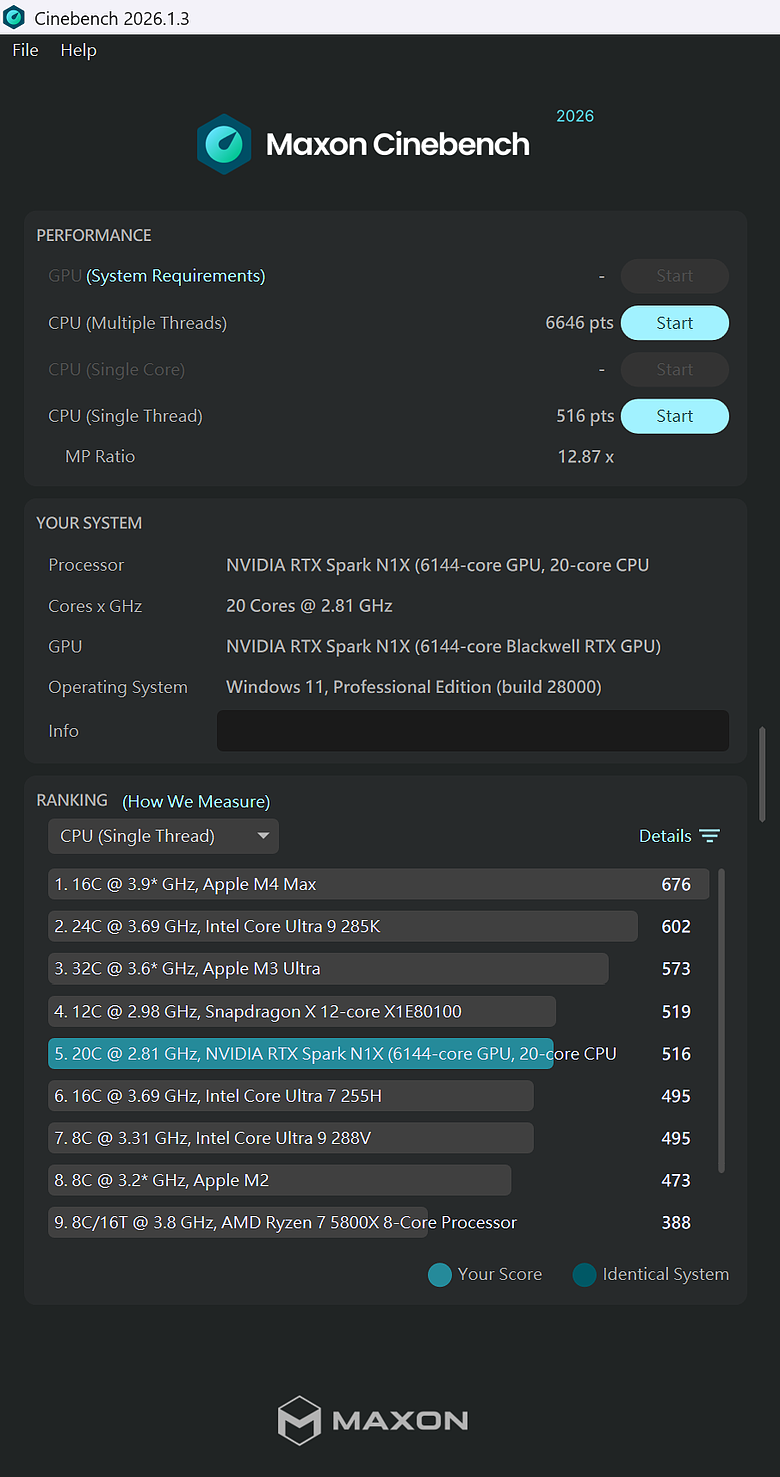
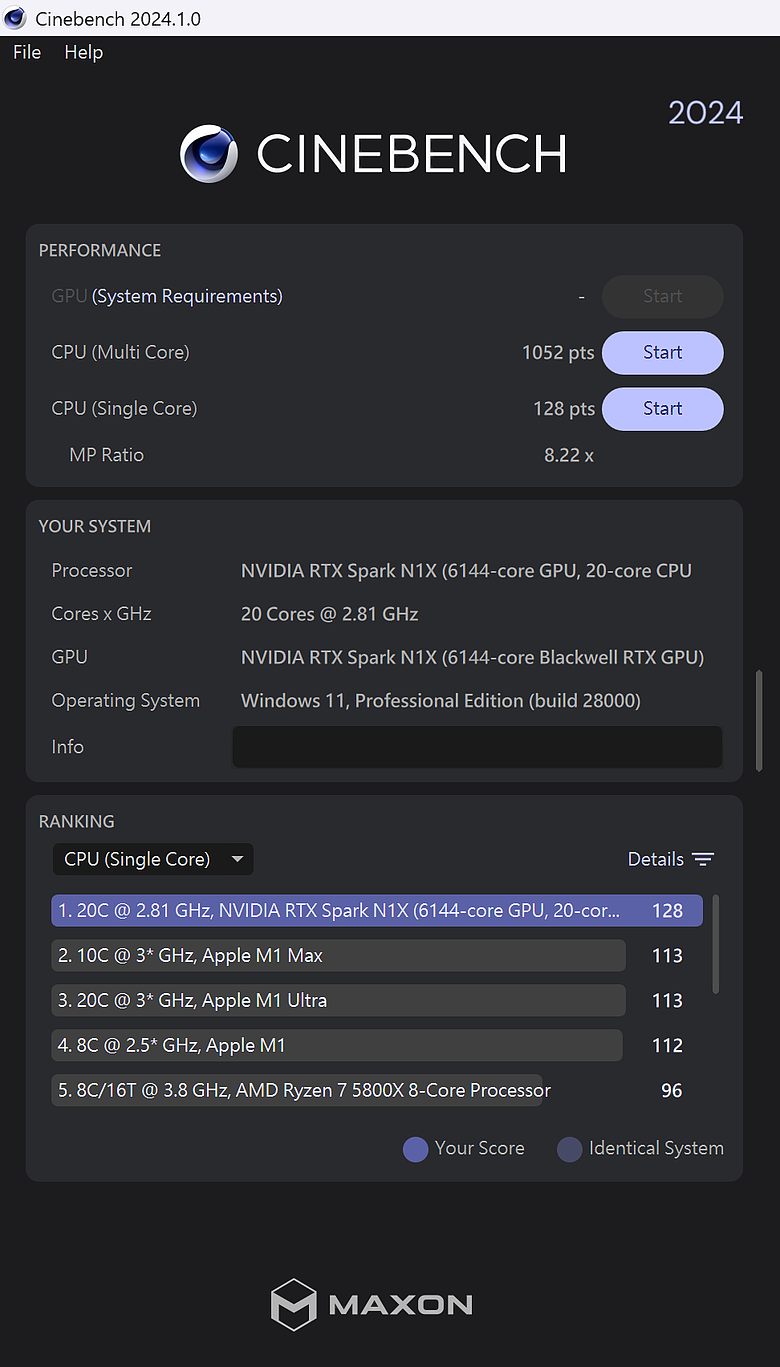
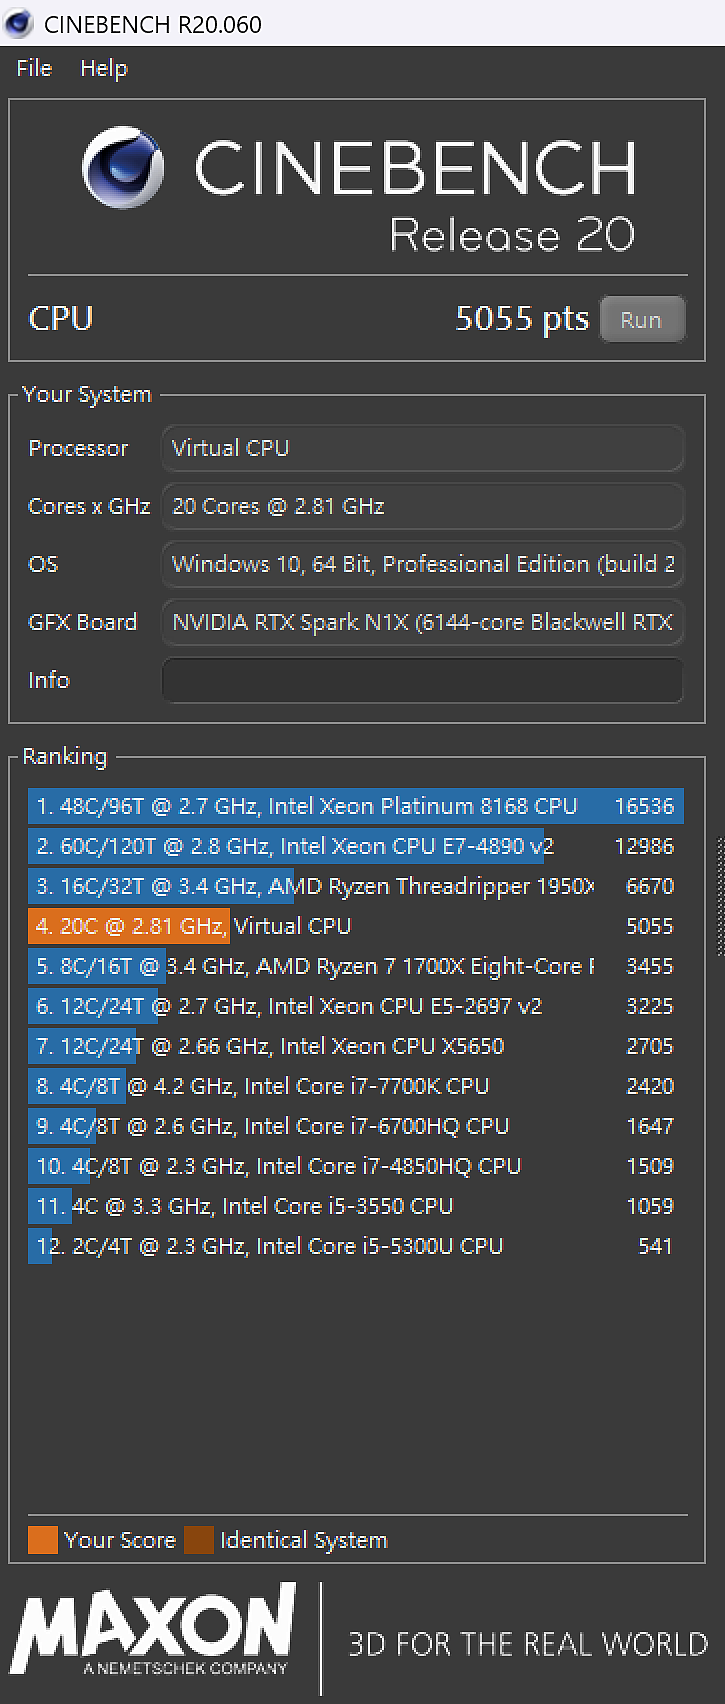
 而換到 ARM 版的 CINEBENCH 2026,ProArt P14 取得 6646 分的多核心效能、516 分的單核心效能;CINEBENCH 2024 則是 17778 分多核、128 分單核的表現,而在 CINEBENCH R20 則是取得 5055 分。
▓ AI 效能測試:
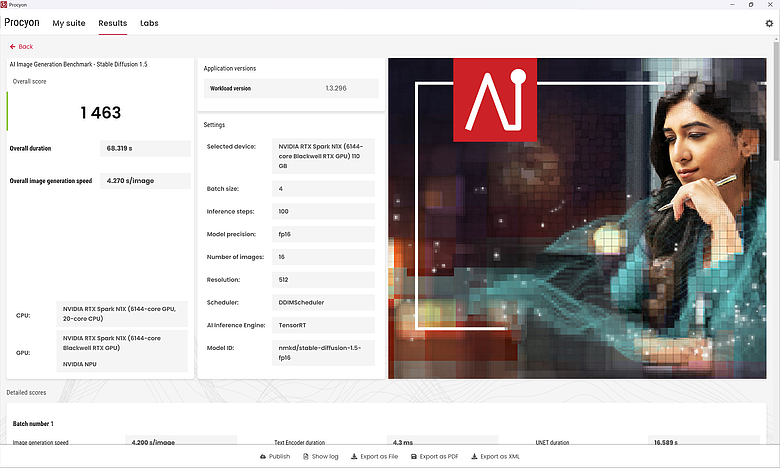
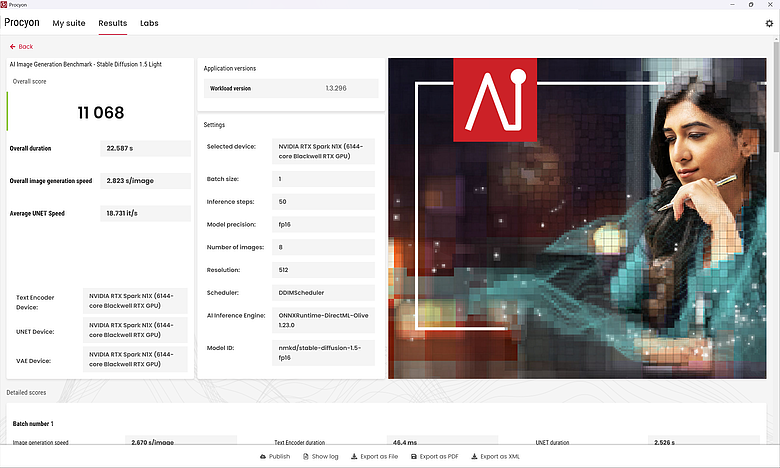
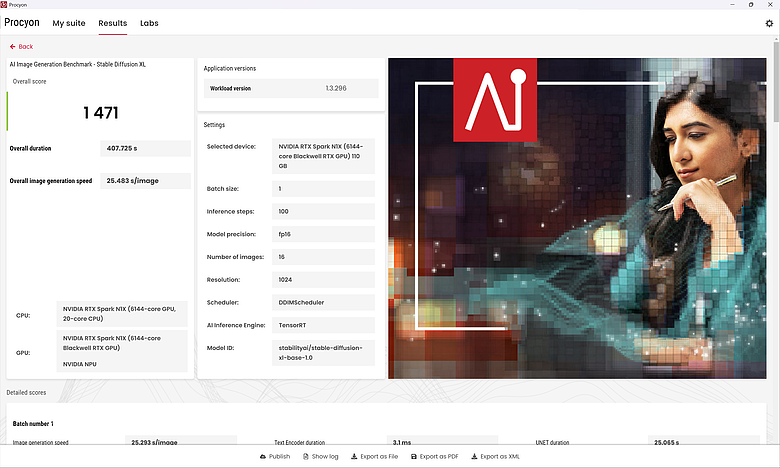
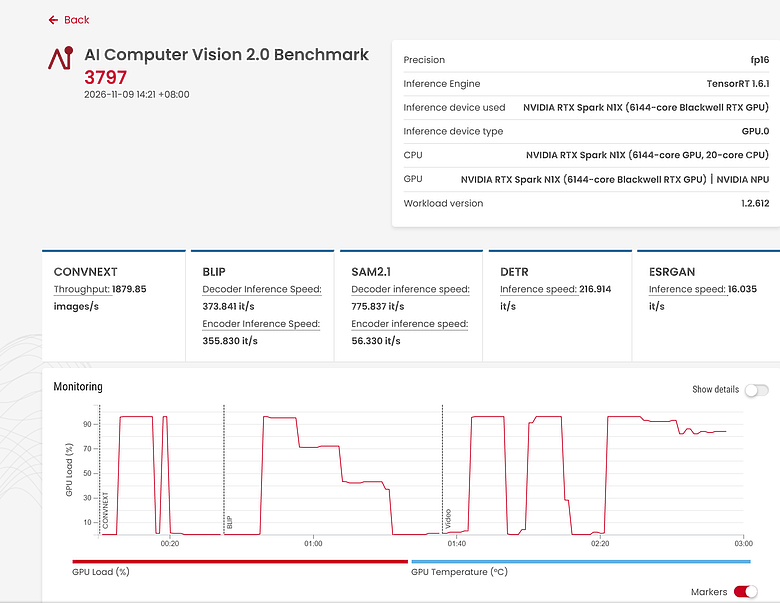 量化的 AI 效能還是得看到 UL Procyon 軟體的基準效能測試結果,首先在 AI Computer Vision 2.0 測試以 TensorRT 1.6.1 作為推論引擎,針對影像辨識與生成模型進行 fp16 精度測試,總分達到 3797 分。各項子測試中展現出恐怖的處理效率,例如基礎影像分類 ConvNeXt 高達 1879.85 images/s,物件分割 SAM2.1 的解碼速度達到 775.83 it/s,而圖文理解 BLIP 與目標偵測 DETR 也分別有 373 it/s 與 216 it/s 的高效能。
配合下方的監控圖表可以看出,在面對高強度的電腦視覺運算時,GPU 負載能長時間維持在高檔且運作穩定,證明這款平台在處理影像分割、特徵萃取與電腦視覺等高負載地端 AI 任務時,具備媲美專業工作站的極致硬體吞吐能力。
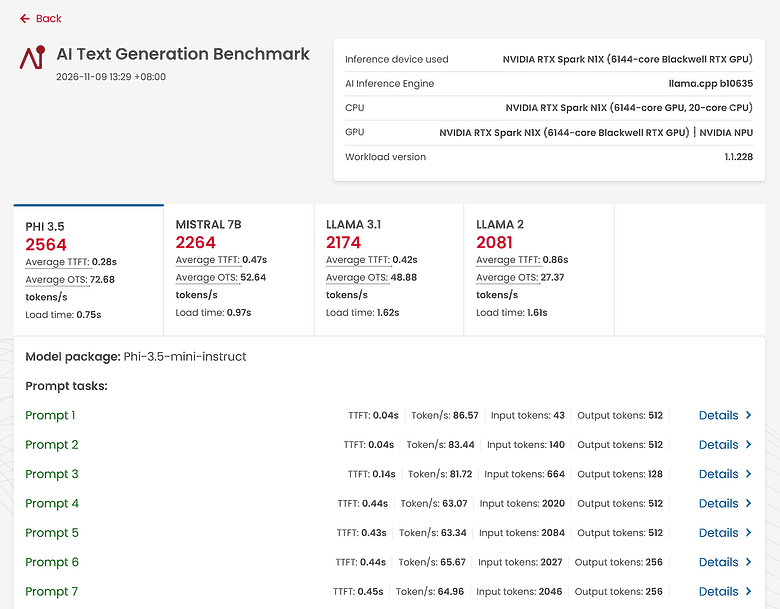
在 AI Text Generation 文字生成測試中,透過 llama.cpp 引擎測試了 Phi-3.5、Mistral 7B、Llama 3.1 與 Llama 2 四款主流地端大模型。其中以微軟的 Phi-3.5 表現最為亮眼,總分達 2564,平均首字延遲 (TTFT) 僅需極快的 0.28 秒,文字生成速度 (OTS) 更高達 72.68 tokens/s。
即便是較大的 Mistral 7B 與 Llama 3.1 也都能維持在 48~52 tokens/s 的流暢水準。這顯示出受惠於 Blackwell 架構 GPU 與 NPU 的強悍算力,這台筆電不僅模型載入極快(多數在 1 秒左右),在執行地端文字推理與對話時也能提供近乎零延遲、極為流暢的即時生成體驗!
- AI 圖片生成測試 (SD1.5)
- AI 圖片生成測試 (SD Light)
- AI 圖片生成測試 (SDXL)
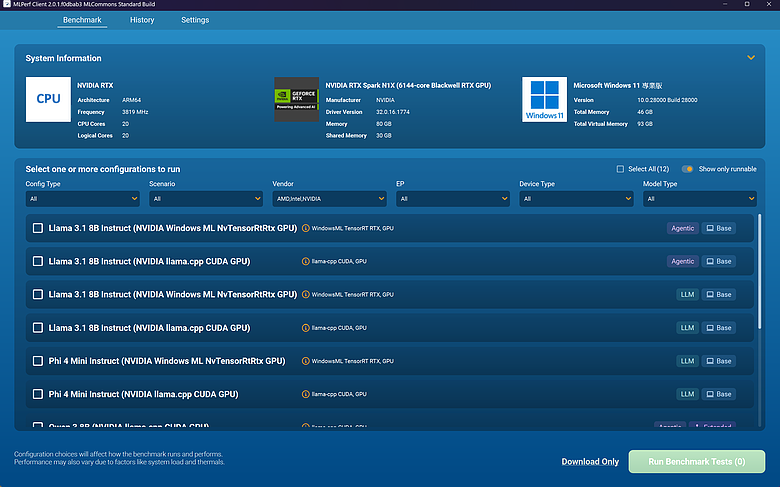
這邊也用專門 benchmark AI 模型的 MLPerf Client 2.0.1 來驗證 ProArt P14 生圖效能,測試前 JB 沒有刻意調高 GPU 記憶體,維持在預設的 80GB。測試模型則有 Llama 3.1、Phi 4 Mini、Phi 4 Reasoning 14B、Qwen 3 8B、Flux 2 Klein 4B 等,後者為圖像生成專用。
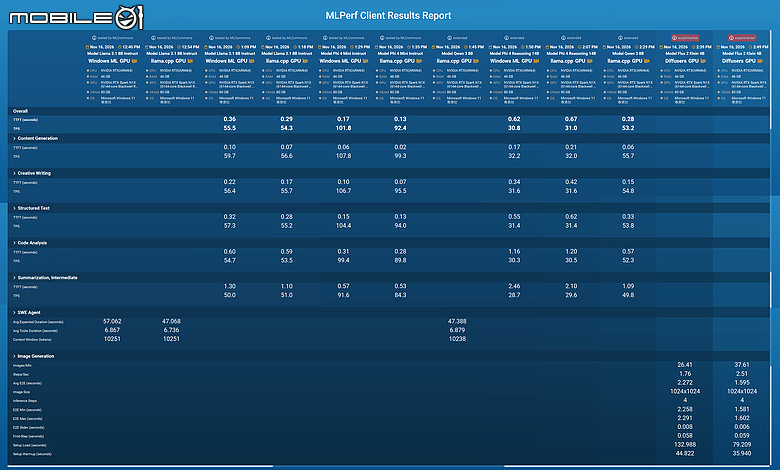
(點擊可放大)
執行 Llama 3.1 8B Instruct 與 Qwen 3 8B,整體文字生成速度約落在每秒 53~56 tokens,首個 token 的等待時間約為 0.28~0.36 秒,顯示這類模型已具備相當即時的互動反應。較輕量的 Phi 4 Mini Instruct 則進一步達到每秒 92~102 tokens;模型規模較大的 Phi 4 Reasoning 14B 約為每秒 31 tokens,首個 token 約等待 0.62~0.67 秒。
同一模型使用不同推論後端,也能看出效率上的取捨。以 Phi 4 Mini Instruct 為例,Windows ML GPU 的整體輸出速度達每秒 101.8 tokens,高於 llama.cpp GPU 的 92.4 tokens,但後者開始輸出的等待時間稍短,因此並非某個後端在所有指標上都占優勢。較長內容的摘要任務,也比一般內容生成需要更多前置處理時間,例如 Phi 4 Reasoning 14B 的摘要首 token 等待時間增加至約 2.1~2.46 秒,持續輸出仍維持每秒約 29 tokens。
AI 代理部分,SWE Agent 測項中,Llama 3.1 8B 使用 Windows ML GPU 的平均預期耗時約為 57.1 秒,改用 llama.cpp GPU 後降至約 47.1 秒,縮短約 17.5%;Qwen 3 8B 搭配 llama.cpp GPU 則約為 47.4 秒。三組的工具執行時間都在 6.7~6.9 秒左右,差距主要反映在工具執行以外的模型處理環節。
圖像生成方面,Flux 2 Klein 4B 的兩組 Diffusers GPU 結果,分別達到每分鐘 26.41 張與 37.61 張,在 1024×1024 解析度、4 步推論設定下,平均端到端生成時間約為 2.27 秒與 1.60 秒,較快一組的產出量提升約 42%。整體來看,P14 在這組小至中型語言模型與輕量生圖測試中,已展現相當實用的本機處理速度
▓ 創作效能測試:
- Blender CPU 渲染效能
- V-Ray 6 渲染效能
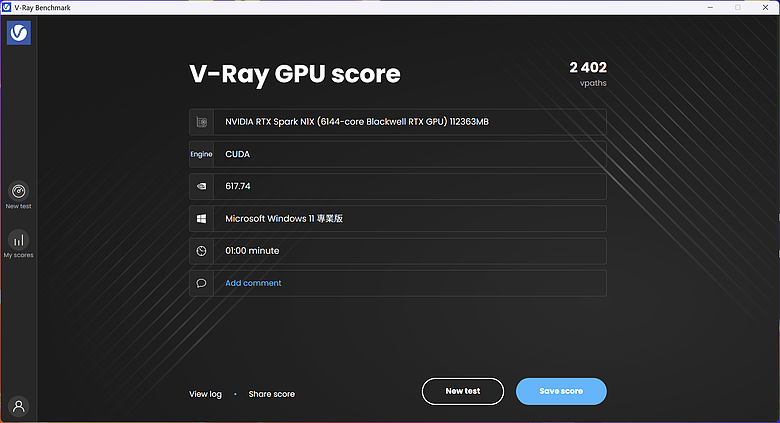
- V-Ray 6 CUDA 渲染效能
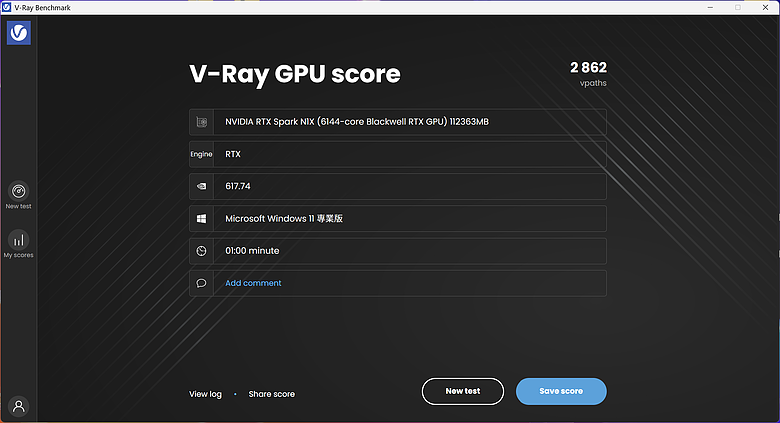
- V-Ray 6 RTX 渲染效能
▓ 記憶體與硬碟讀寫效能測試:
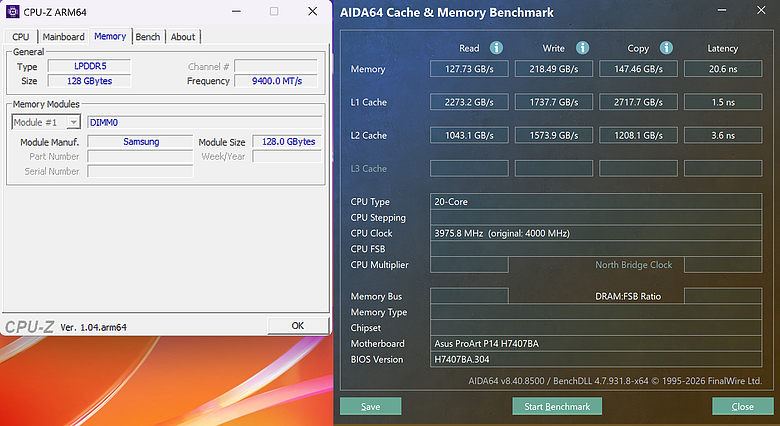
在記憶體配置上,ProArt P14 搭載高達 128GB 的三星 LPDDR5X 統一記憶體,運行時脈達到驚人的 9400 MT/s,為地端運行大型 AI 模型與多軌高解析影音剪輯提供極為充裕的暫存空間。透過 AIDA64 記憶體基準測試,其實際讀取/寫入/拷貝速度分別為 127.73 / 218.49 / 147.46 GB/s,而整體延遲更僅有極低的 20.6 ns;受惠於 NVIDIA RTX Spark 平台的統一記憶體高頻寬優勢,CPU 與 GPU 能以極低延遲共享龐大資料集,大幅提升大型專案與 AI 運算時的吞吐效率。
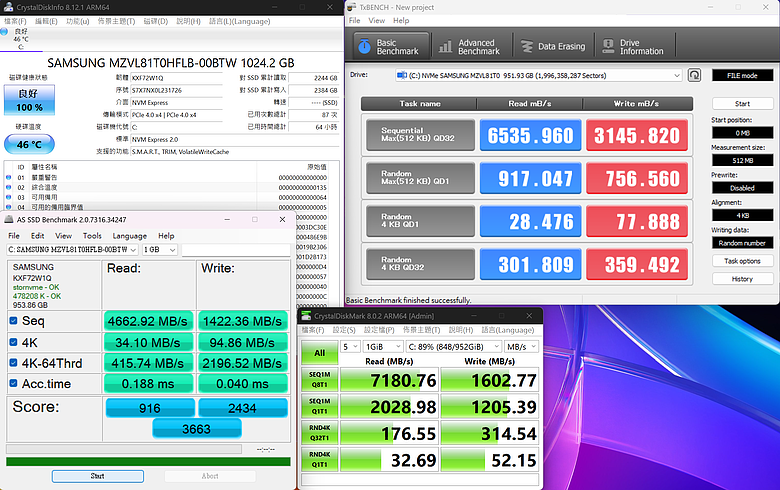
存儲則是採用 1TB 三星 M.2 PCIe Gen4.0x4 的 SSD 固態硬碟,其在 CrystalDiskMark 測得循序讀取 7180.76 MB/s、循序寫入 1602.77 MB/s;在 TxBench 則跑出循序讀取 6535.960 MB/s 、循序寫入 3145.820 MB/s;至於 AS SSD Benchmark 亦獲得總分 3663 分(循序讀取 4662.92 MB/s、寫入 1422.36 MB/s)。整體而言,超過 7000 MB/s 的極速讀取能力能讓大型剪輯軟體、遊戲素材與地端 AI 模型在數秒內快速載入,日常創作的流暢度完全無虞。
▓ 圖形測試:
- Night Raid
- Wild Life Extreme
- Speed Way
- Port Royal
- Solar Bay Extreme
- Steel Nomad
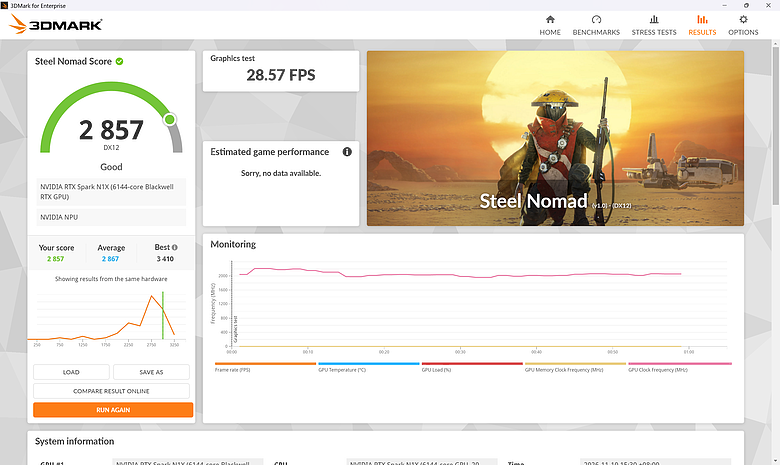
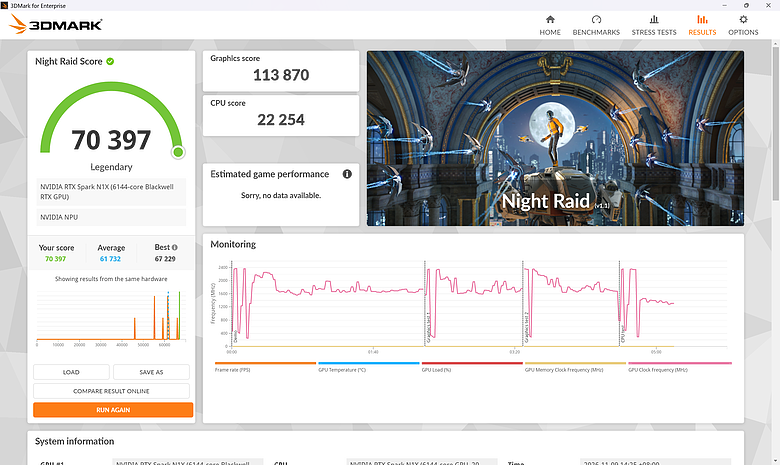
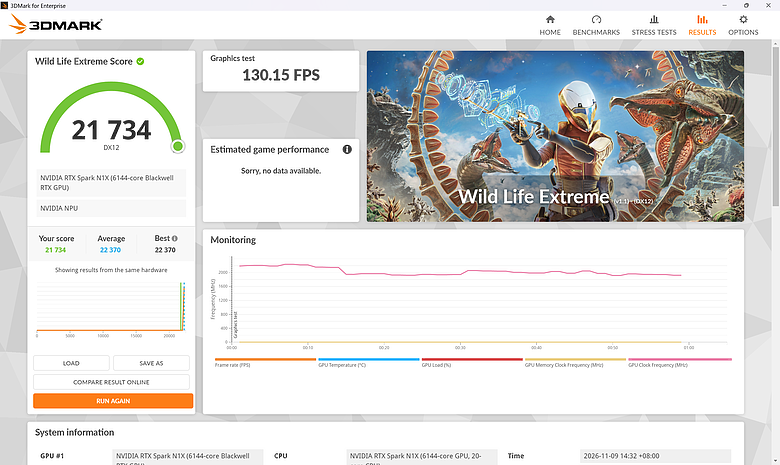
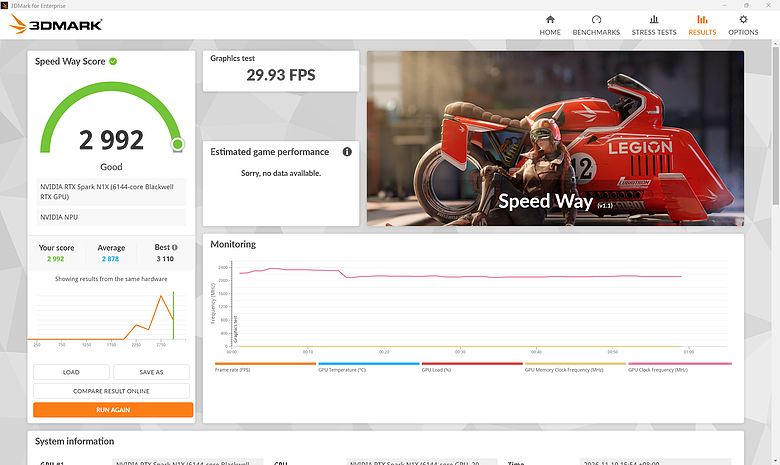
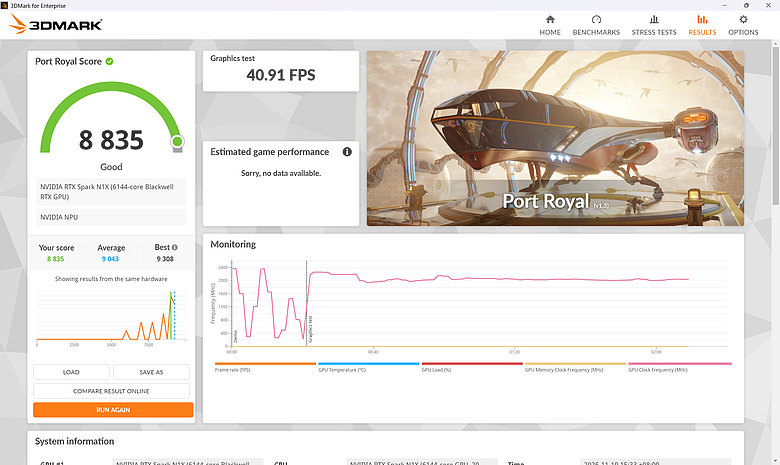
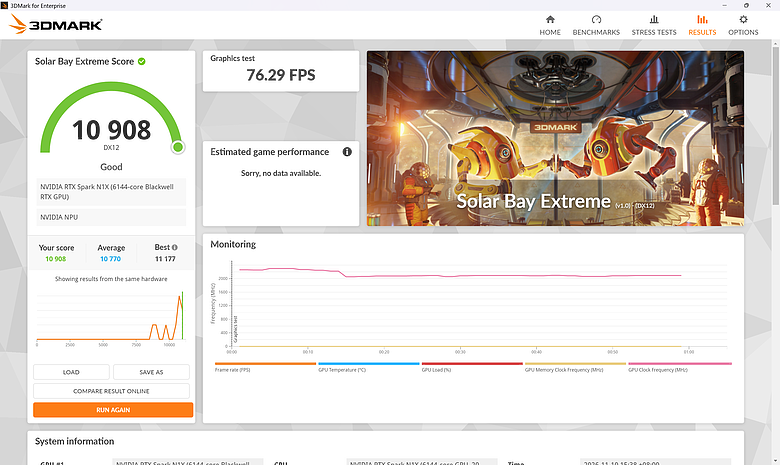
受惠於新世代 Blackwell RT 核心,在看即時光線追蹤效能的 Port Royal 取得 8835 分的優異表現;跨平台重度光線追蹤測試的 Solar Bay Extreme 測試跑出 10908 分、76.29fps 高於同級硬體絣均表現;而在 Speed Way 這個 DirectX 12 Ultimate 的旗艦級綜合光追測試模式中,該機則交出 2992 分,效能穩逼近 30fps 大關,勝過我之前測試、搭載 RTX 5060 的 ROG Zephyrus G16 GU606AM。最後在 Steel Nomad 中則是拿到 2857 分與接近 30fps 的穩定輸出,實力足以對標中階筆電獨顯了~
- Fire Strike
- Time Spy
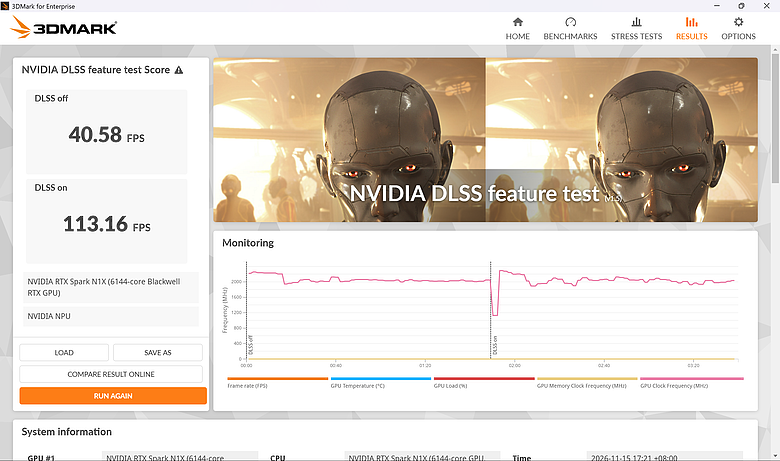
- DLSS feature test (2x)
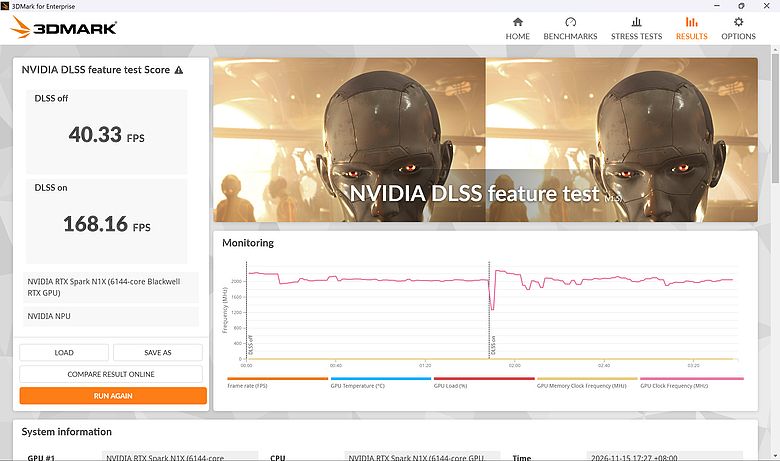
- DLSS feature test (4x)
▓ 遊戲效能測試:
- 圖形設定
- DLSS 影格產生模式
受惠於單晶片整合的 6144 核心 Blackwell 架構 GPU,這顆整合式顯卡不僅具備跨入主流獨顯級距的硬實力,更能完整支援 DLSS 5 (包含多畫格生成與 3D 引導式神經渲染)以及 NVIDIA Reflex 低延遲技術,這意味著它不只能跑得動 3A 遊戲,更能透過 AI 畫格生成與超解析度技術大幅推升幀率與畫面細膩度,讓創作者在工作之餘,也能在 14 吋輕薄機身上享受真正流暢且畫質在線的次世代遊戲體驗。
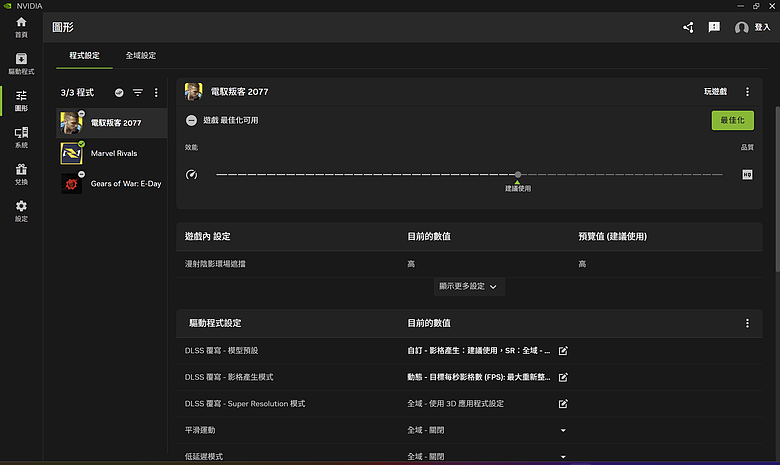
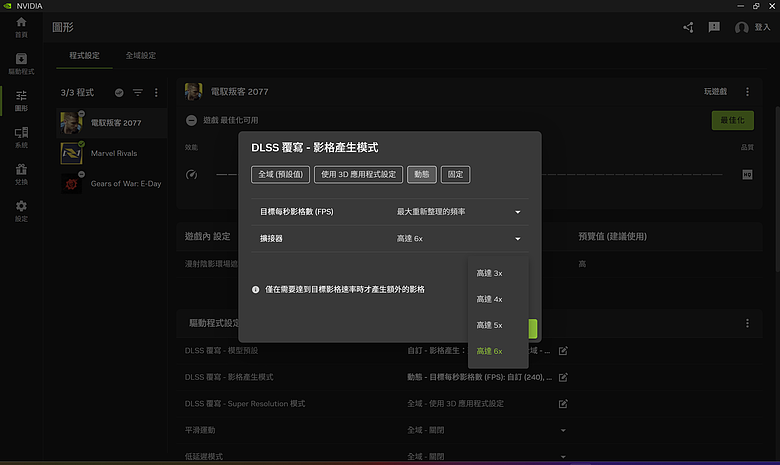
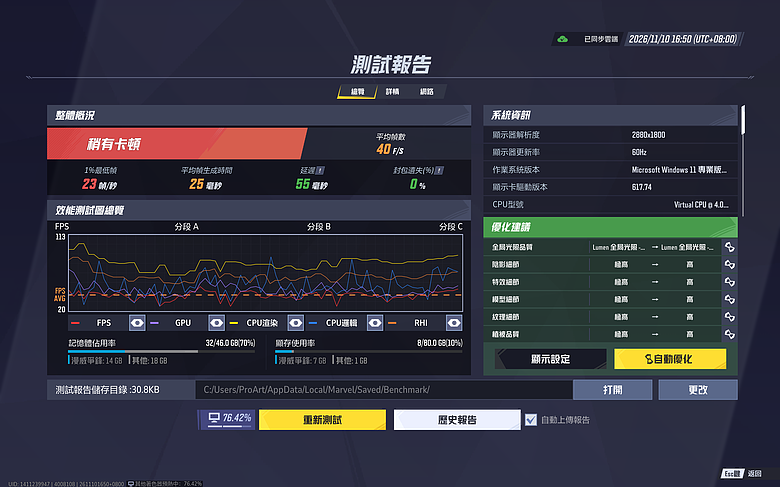
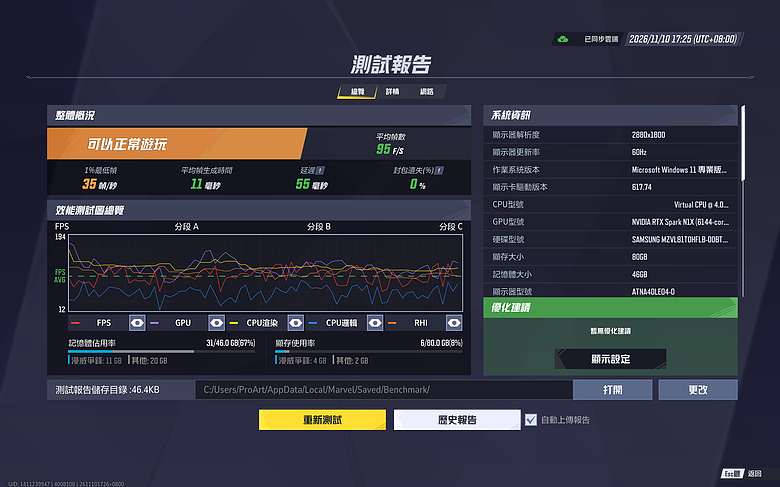
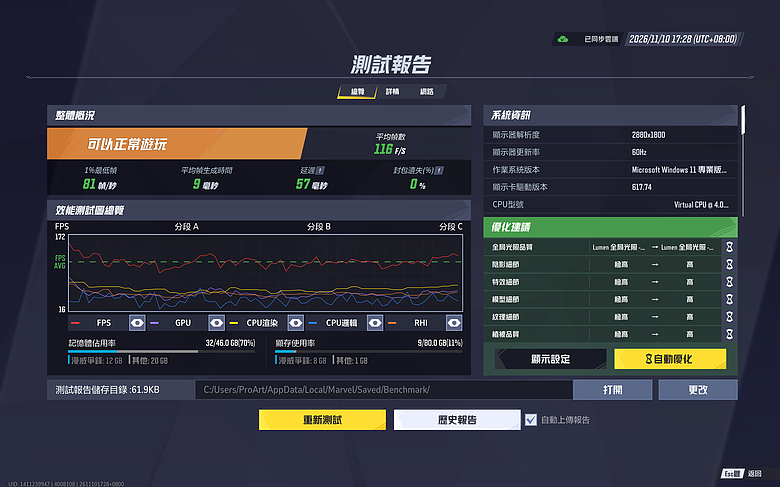
而在遊戲圖形設定方面,NVIDIA App 除了提供一鍵最佳化之外,也能逐一設定「DLSS 覆寫」,包括影格產生方式、超級解析度模式等,前者透過「擴接器」設定,最高可實現 6x 的影格生成!
- 漫威爭鋒|DLSS 關
- 2x 影格生成
- 4x 影格生成
- 6x 影格生成
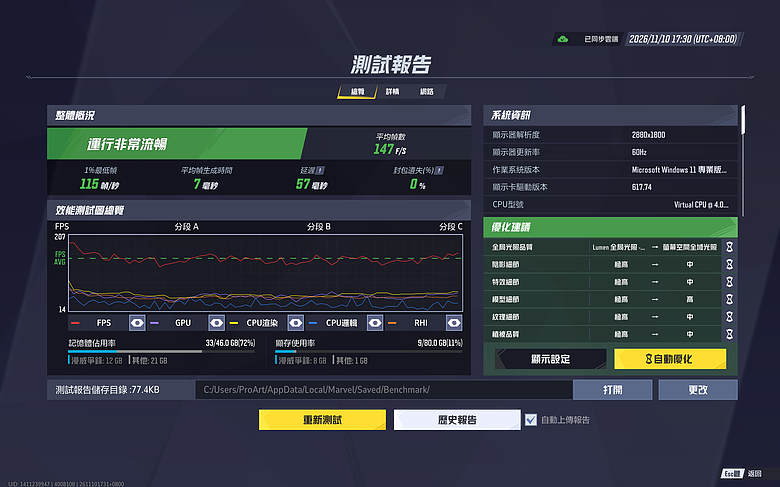
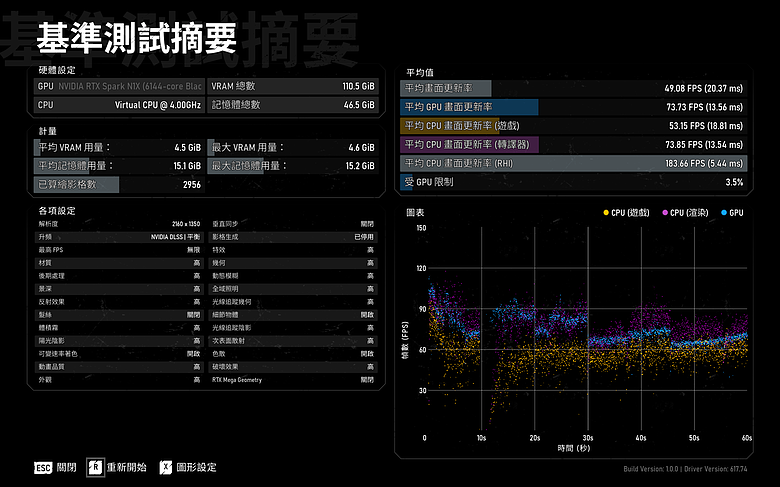
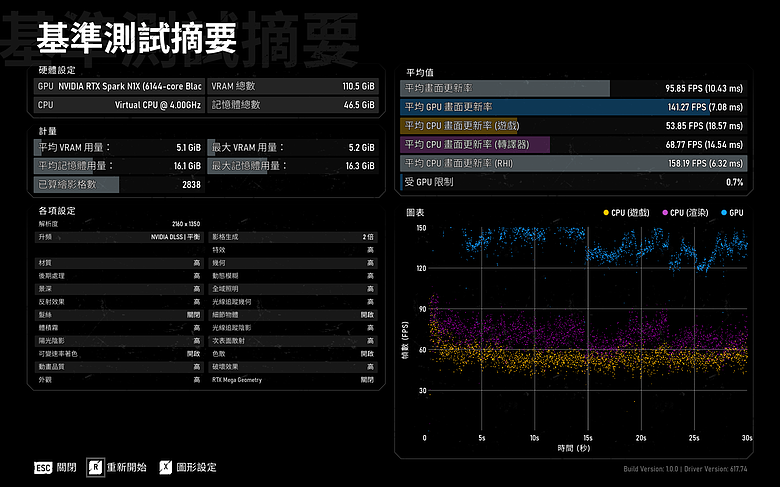
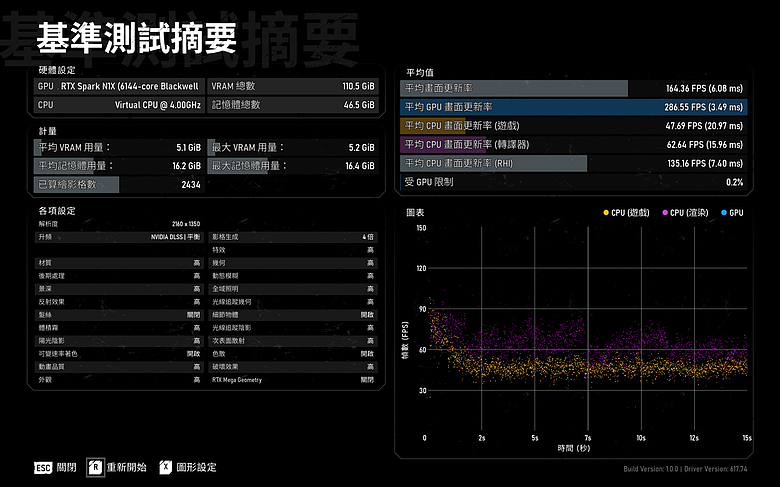
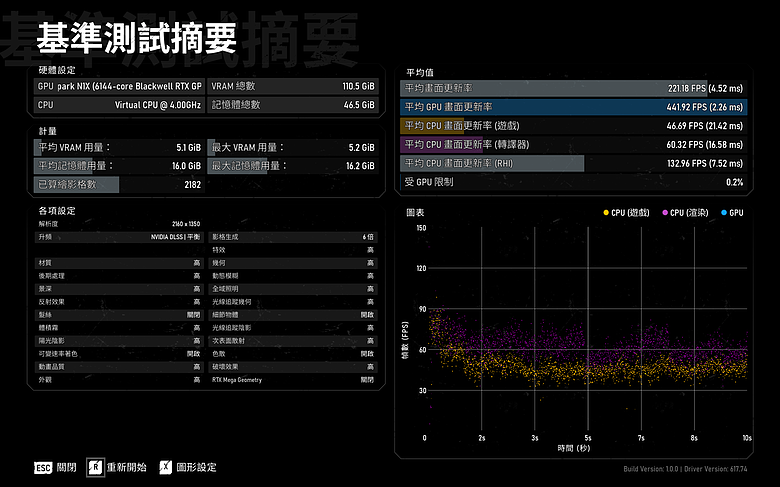
雖然帳面上不若電競筆電 DLSS 6x 多影格生成的表現,但已是過去無獨顯筆電所無法達到的境界了。- 戰爭機器:事變日|DLSS 關
- 2x 影格生成
- 4x 影格生成
- 6x 影格生成
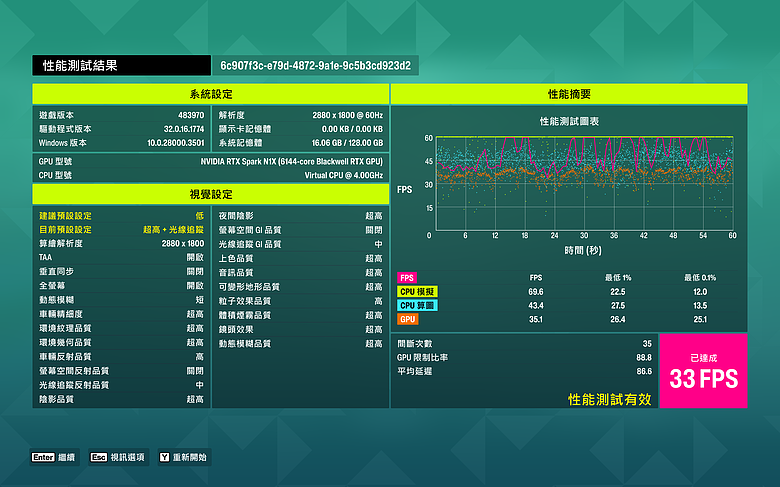
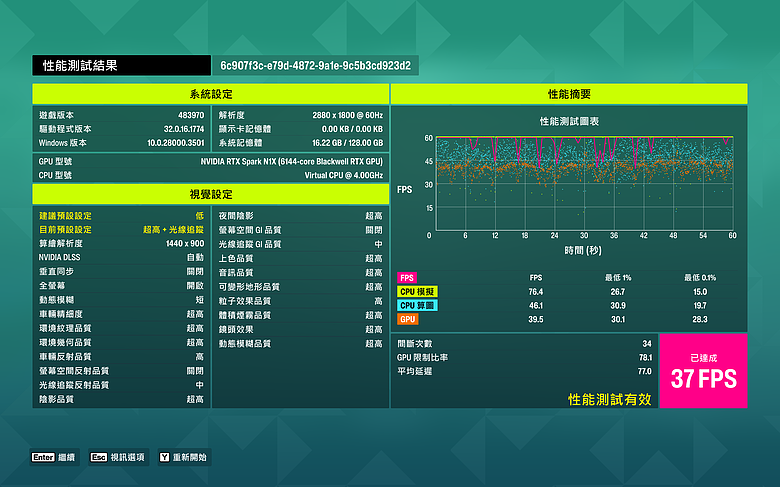
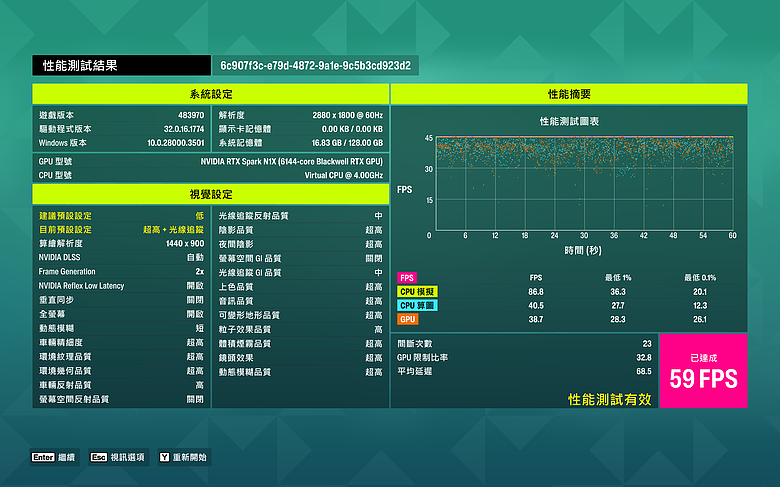
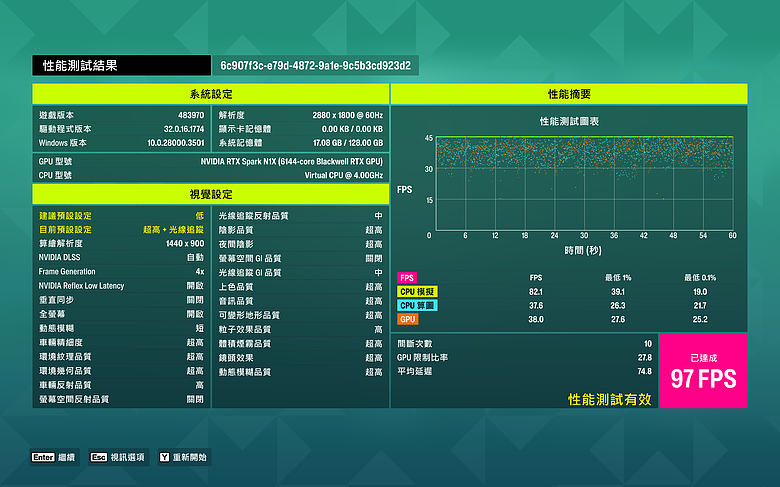
- 極限競速:地平線6|DLSS 關
- DLSS 開
- 2x 影格生成
- 4x 影格生成
- 電馭叛客 2077|DLSS 關
- 2x 影格生成
- 4x 影格生成
- 6x 影格生成
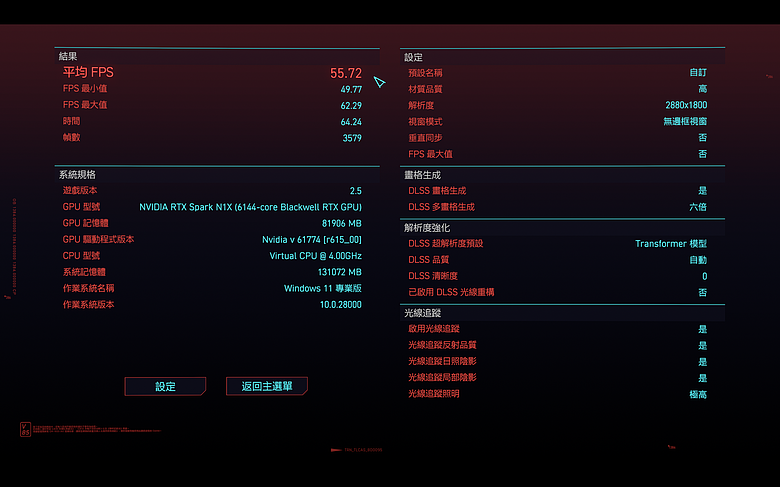
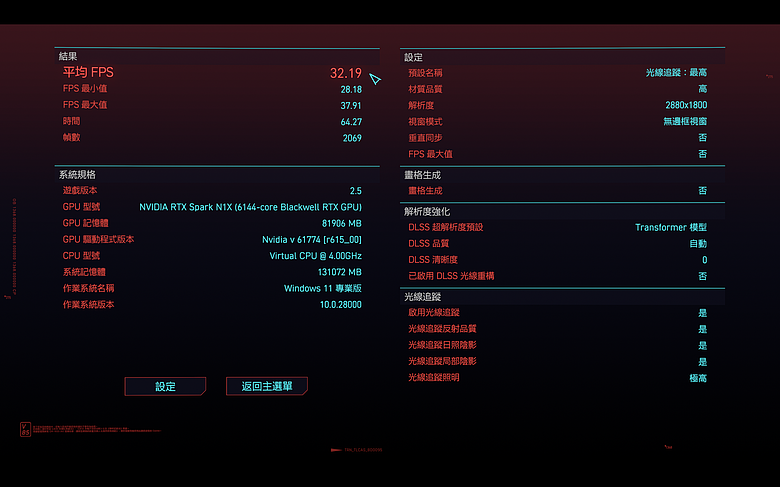
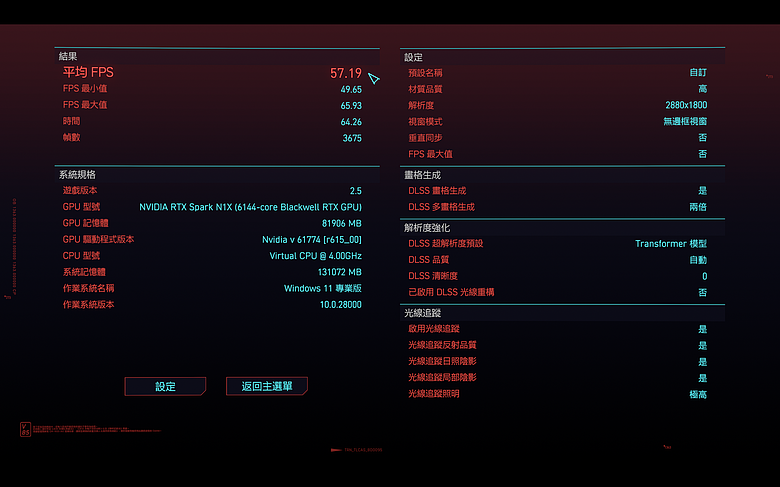
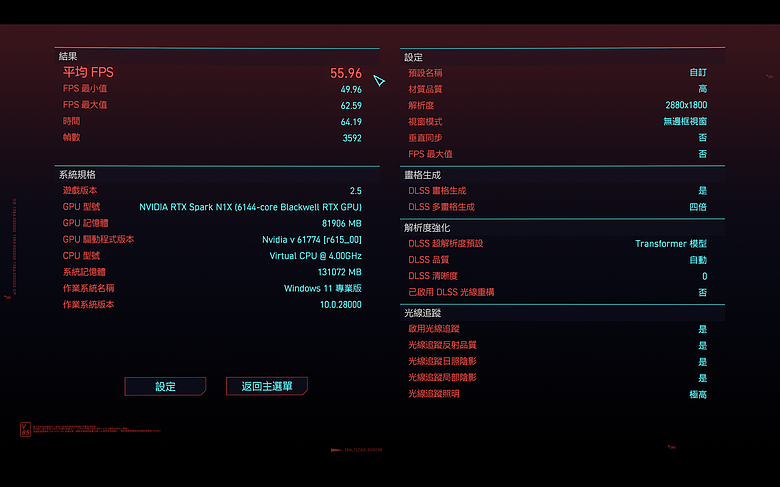
從上方結果可見,RTX Spark N1X 所搭載的 Blackwell GPU 在面對一票 3A 大作,在不降解析度的前提下,最高圖形品質只要啟用 2x 影格生成,就能交出超過或接近 60fps 的順跑表現!雖然這款的受眾應該...不太會把它來來當電競筆電使用吧?(畢竟同樣價格可以買 3 台高階電競款了

值得一提的是,128GB 的統一記憶體不僅是地端 AI 利器,對遊戲體驗同樣帶來顯著加分。有別於傳統中階獨顯筆電常受限於實體 VRAM,在高解析度下開啟極高材質與光線追蹤時容易「爆顯存」導致卡頓,統一記憶體架構讓 Blackwell GPU 能直接動態調用龐大的記憶體池,徹底免除 VRAM 容量焦慮;同時受惠於 9400 MT/s 超高頻寬與 CPU/GPU 共享記憶體的特性,大幅減少開放世界遊戲在高速載入場景時的貼圖延遲,就算背景同時掛著直播或錄影應用,也能維持穩定流暢的幀率表現。
▓ 散熱效能測試:
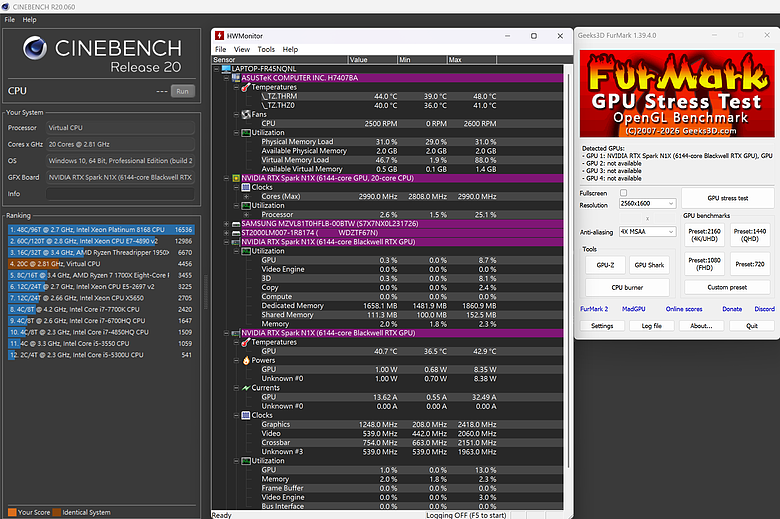
- 待機時硬體溫度
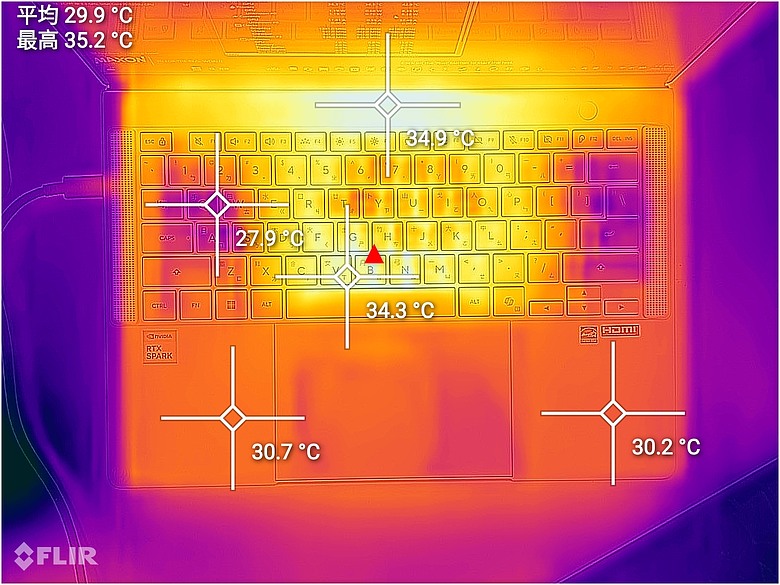
- 待機時機身溫度
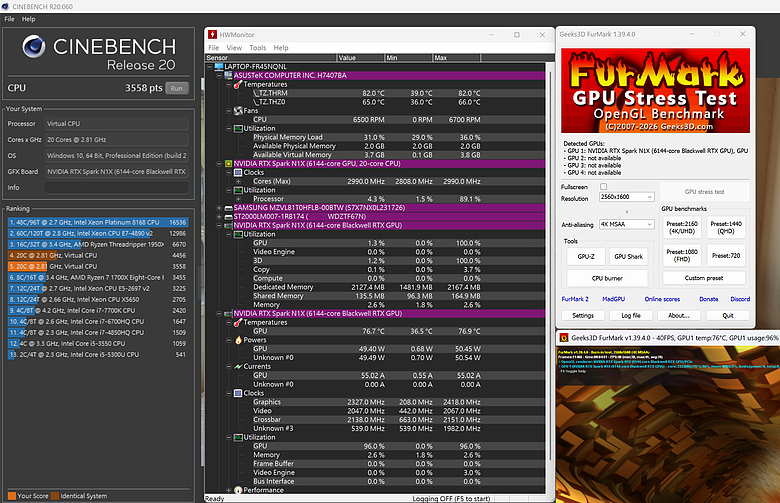
- 測試時硬體溫度
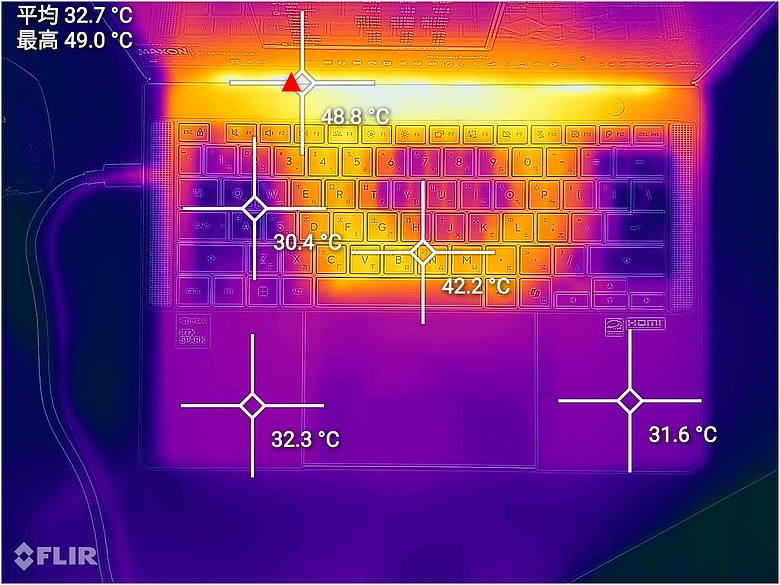
- 測試時機身溫度
- 測試時風扇噪音

▓ 續航力測試:
- 鋰電池資訊
- PCMark 10 應用程式續航時間
- 充電時間
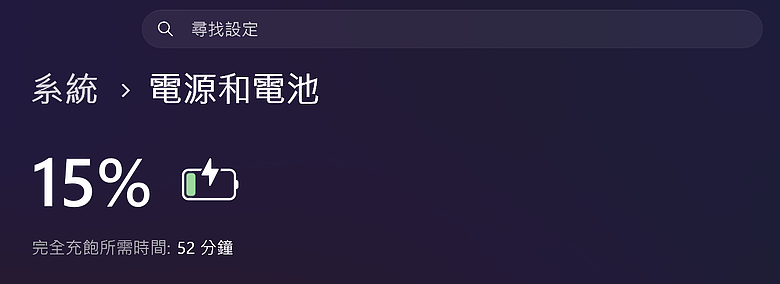
透過隨附的 140W 變壓器為 ProArt P14 充電,從 15% 充至 100% 滿電量約需 52 分鐘,速度表現就頗具水準。▌測試總結 ▌
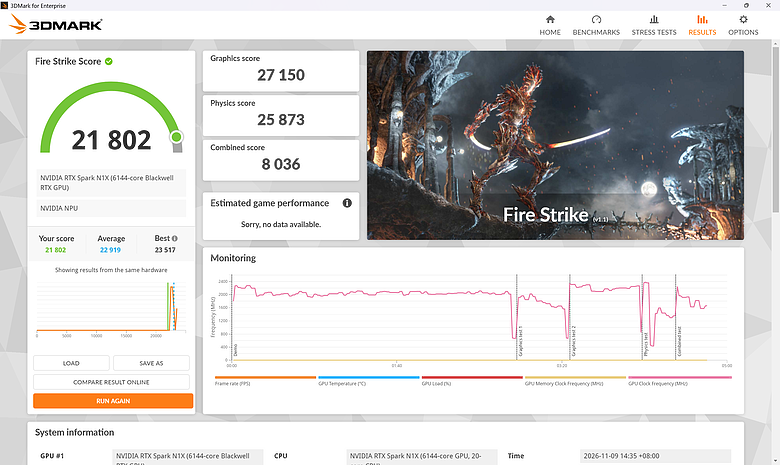
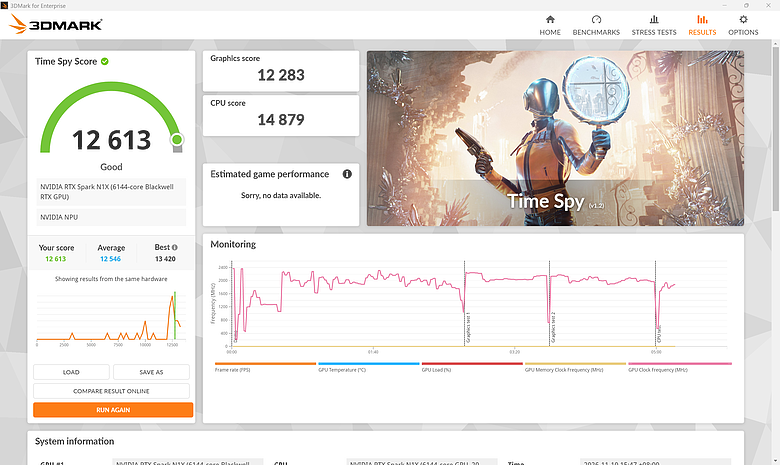
全新 ProArt P14 將高階創作筆電需要的螢幕、機身質感與運算能力整合得相當完整,不到 1.5Kg 的金屬機身便於攜帶,3K 120Hz Tandem OLED 觸控螢幕兼顧細緻度、亮度與色彩表現,再加上 USB4、HDMI 與 SD 讀卡機,日常創作所需的連接介面也沒有因為機身縮小而大幅妥協。效能方面,RTX Spark N1X 的 CPU 多核心表現接近同功耗 Ryzen AI Max+ 395,GPU 在部分圖形測試中也具備 RTX 5060 筆電顯示卡等級的實力,讓 P14 在輕巧的外型下,仍保有處理高負載創作工作的能力。
128GB 統一記憶體配置更進一步拉開其與一般輕薄創作筆電的用途差異,面對大型地端模型,顯示記憶體容量往往比運算效能更早成為限制,而大容量統一記憶體搭配 CUDA 加速,讓 ProArt P14 能承載傳統獨顯筆電受限於 VRAM 容量而難以完整載入的模型。外媒在特定 Comfy UI 生圖流程中,甚至測得接近 RTX 5080 桌機的完成時間,雖然語言模型推論仍由桌機領先,但對一台輕薄筆電而言,能把這樣的模型容量與生成能力隨身帶著走,已是相當鮮明的優勢。
作為 Windows on Arm 筆電,P14 執行原生應用與模擬 x86 軟體時仍有表現差異
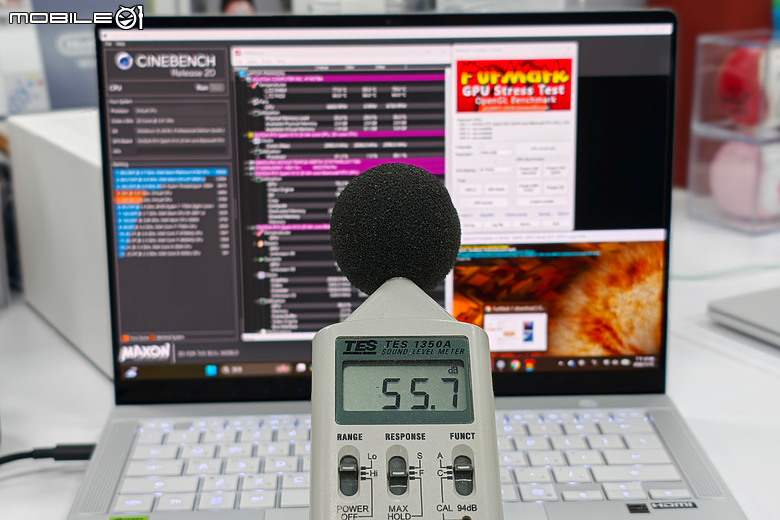
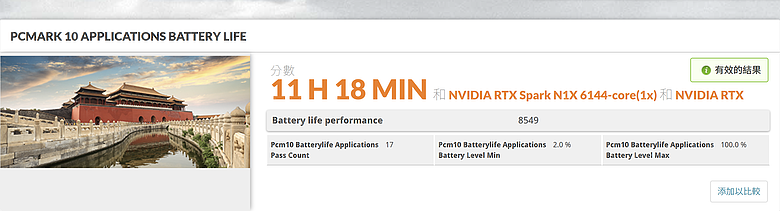
 這次使用的創意及 AI 工具大致能順利運作,但安裝特定測試軟體時也遇過當機,軟體相容性仍有提升空間。ProArt P14 在高負載下的風扇聲相當明顯,約 11 個半小時的續航考量到配備 90Wh 電池,也稱不上特別突出。不過值得肯定的是,電池供電時仍能維持接近插電狀態的運算效能,這次 CPU 測試差距約在 4% 以內,讓外出使用時不必因為暫時離開插座,就犧牲大量處理效能。
至於在 P14 上執行地端 AI 代理,這次的體驗已經展現實際用途。Hermes Agent 能協助圖片後製、讀取專案文件與修改網站設定,將本機模型的能力延伸到具體操作;不過,自行加入未要求的內容、誤判錯誤原因,以及反覆推理拉長等待時間等情況仍會出現(不排除是 Qwen 理解問題或是我指令下得不夠清楚)。以目前的完成品質來看,範圍明確、已有工具可呼叫的任務最能發揮它的價值,不過,成果還得保留人工檢查就是。
JB 認為,ProArt P14 最值得關注的地方,是將 128GB 統一記憶體、RTX Spark N1X 與高品質 Tandem OLED 螢幕,集中在便於日常攜帶的 14 吋機身裡。相較於偏重大畫面、擴充能力或翻轉操作的同級機種,ProArt P14 的特色就是在縮小體積與重量的同時,保留大型地端模型所需的資源及創作介面(目前市面上的競品中,微軟、聯想與微星的 RTX Spark 機種分別為 15 吋、15.3 吋及 16 吋,沒有像華碩有提供 14 吋大小,當然重量也是最輕的一款)。
接近新台幣 25 萬元的價格確實昂貴,單一 M.2 插槽也限制了後續儲存擴充;但對經常往返工作室、拍攝現場與客戶端,又有明確本機 AI 需求的創作者與開發者而言,這份投入買到的是一套能長期隨身攜帶的完整工作環境。大容量、運算能力與行動性的結合,正是 ProArt P14 在高階創作筆電市場中最具辨識度的價值
▌小惡魔福利社 Part.1 ▌
 登入回文還可以看到福利社資訊